看板做得再漂亮,异常发生时没人知道,它就只是一块显示屏。运营看板工具能否支撑运营动作,取决于三个参数:刷新频率、告警阈值和推送规则。频率决定多快看到变化,阈值决定什么算异常,推送决定谁在多久内接手。三者应按顺序确定:先看决策节奏,再划异常边界,最后设计通知路径。
一、刷新频率:匹配决策节奏
看板刷新频率不只是技术参数,更是管理参数。设成系统允许的最快值,往往会增加查询压力和视觉干扰。
1. 用三个问题确定刷新档位
配置前先回答:数据多久变化一次;异常出现后多久必须发现;发现后是否有明确动作。如果数据一天只结算一次,秒级刷新往往只是重复展示同一结果;如果一次投放故障能在10分钟内消耗大量预算,分钟级刷新就可能错过处置窗口。刷新频率应由决策周期倒推,而不是由技术上限决定。
2. 刷新快不等于数据新
前端刷新和数据更新是两件事。例如,看板每10秒重绘,源系统却每小时才同步一次,用户看到的只是被反复包装的旧数据。更稳妥的做法是给每个数据块标注更新时间,区分实时采集、批次同步和人工录入;超过预期间隔就提示延迟,而不是继续展示旧值。微软Learn的告警课程《减少无意义和无法采取行动的警报》把数据新鲜度列为系统正确性的一项。可视化上的实时感,不能替代数据本身的新鲜度。
3. 分级刷新更划算
更经济的方式是混合刷新:关键异常由数据变化触发,汇总指标按固定周期聚合,既让重要变化及时出现,也避免整块看板高频查询。
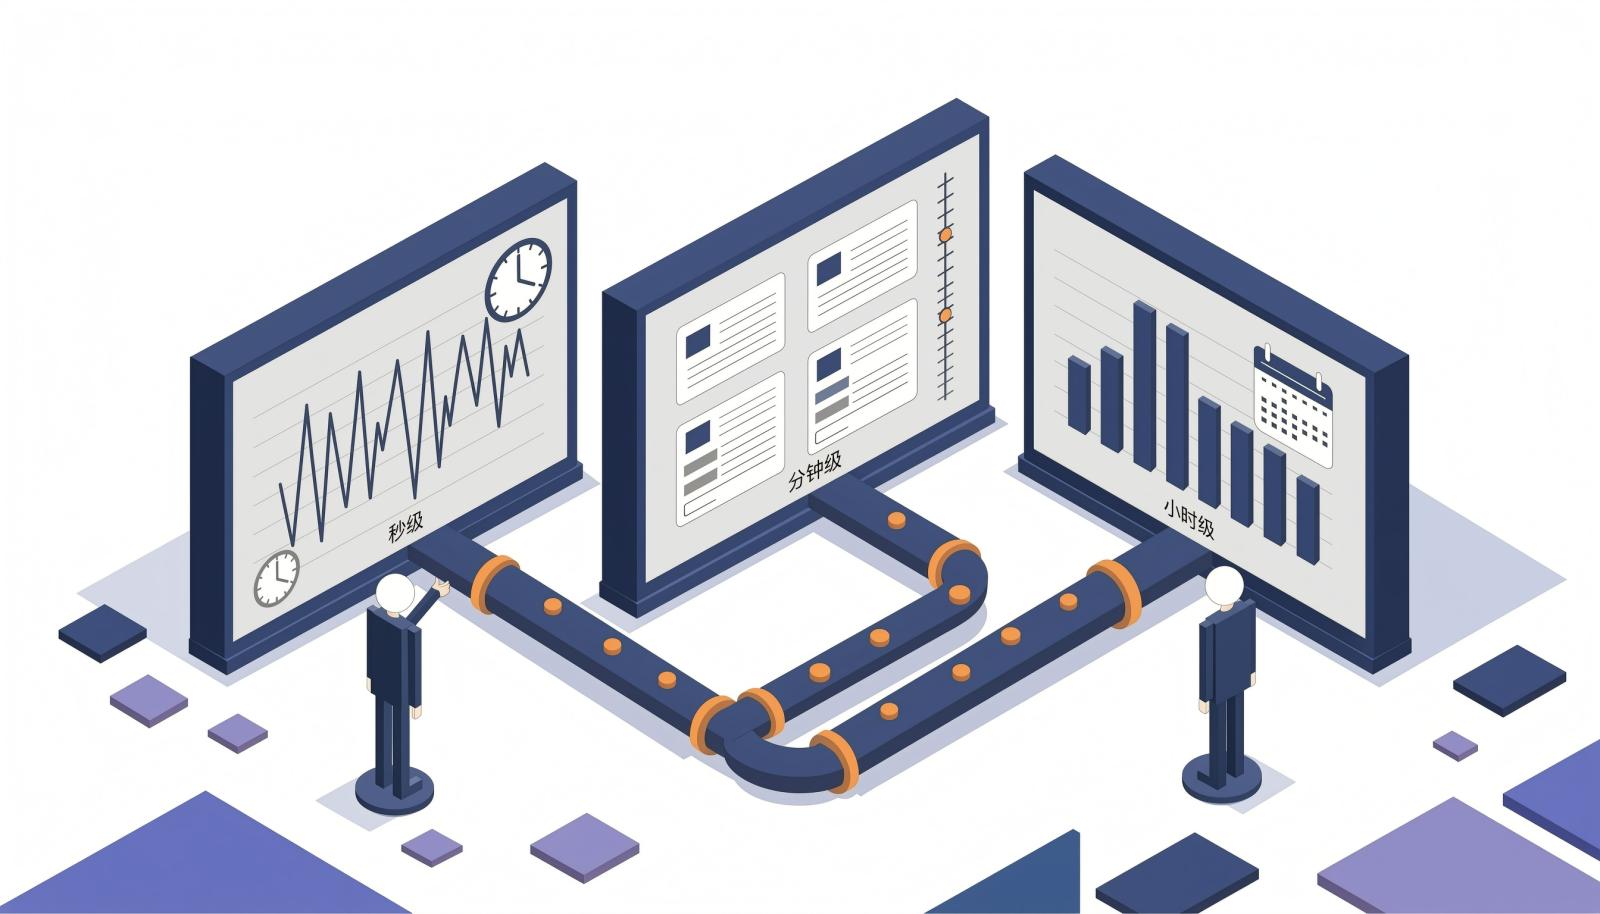
三类看板可以这样设置。
| 看板类型 | 典型指标 | 建议刷新频率 | 配置要点 |
|---|---|---|---|
| 实时处置 | 故障、支付失败、大促流量 | 5到15秒 | 事件触发,标注延迟 |
| 日常运营 | 订单、线索、工单、转化率 | 1到5分钟 | 定时刷新,查询错峰 |
| 经营复盘 | 收入、成本、库存周转 | 1小时或每日 | 标注批次时间 |
差别来自决策窗口,而不是指标重要性。越靠近一线处置,越需要短周期。
二、告警阈值:分清静态与动态
设置告警阈值,不是为了制造更多告警,而是把正常波动和需要干预的异常分开。太松会漏报,太紧会让团队逐渐忽略通知。
1. 三类指标,三种阈值
边界稳定的指标用静态阈值,例如库存下限、预算余额、证书剩余天数。有明显周期的指标用动态阈值,可参考历史同期水平、近期均值或环比变化幅度设定边界,能适应工作日与周末、淡季与大促的差异,但前提是历史数据干净。核心经营指标适合组合阈值:同时设置静态和动态两类规则,静态规则守住底线,动态规则识别偏离。
三类阈值的适用边界如下。
| 阈值类型 | 适用指标 | 优点 | 风险 |
|---|---|---|---|
| 静态 | 库存下限、预算余额、证书剩余天数 | 易解释、易审计 | 业务变化后失效 |
| 动态 | 有周期波动的转化率、流量 | 适应季节与活动 | 历史数据异常时基线失真 |
| 组合 | 核心经营与交付指标 | 兼顾稳定与灵敏 | 维护成本较高 |
选择时先看指标有没有稳定边界;没有稳定边界,再考虑动态基线。
2. 条件、持续时间、影响范围
设计一条规则时,至少要明确三件事:触发条件、持续时间、影响范围。只看瞬时值,页面抖动和正常峰值都会触发;加上持续时间,才能过滤短时波动。Prometheus官方文档《Alerting》建议为小波动留出余量,并给出参考:如果批处理任务在覆盖两次完整运行的时间窗口内仍未成功,就应告警。每4小时运行一次、单次耗时1小时的任务,10小时左右可作为阈值。阈值应同时写清触发条件、持续时间和影响范围,并与业务周期匹配。
影响范围可按受影响用户数、渠道数、是否涉及结算或对外承诺划分;范围越大,级别越高。
3. 分级按影响,不按数字大小
指标涨幅大,不代表影响大。低流量渠道转化率跌两成,可能只是正常波动;核心接口错误率升两个百分点,却可能直接影响成交。告警分级应看用户、收入和关键业务功能是否受影响。
三、告警推送:让每条告警找到负责人
推送不是把消息发出去,而是把问题交到能处理的人手里。判断一条告警该不该推,看四个条件:紧急、重要、可行动、真实。四个条件缺一个,都容易变成干扰信息。
1. 先做四道筛选
微软Learn的告警课程把可执行告警概括为四点:现在就需要处理;会影响用户、收入或关键业务功能;接收者能采取具体动作;确实代表真实问题。不能行动的通知不建议发送;需要别的团队处理的,直接发给对应团队;已经恢复的历史问题,一般不再重复通知。每条告警要写清影响对象、判断依据、建议动作和责任人,否则接收者还得回到看板里查找。
2. 渠道跟着紧急程度走
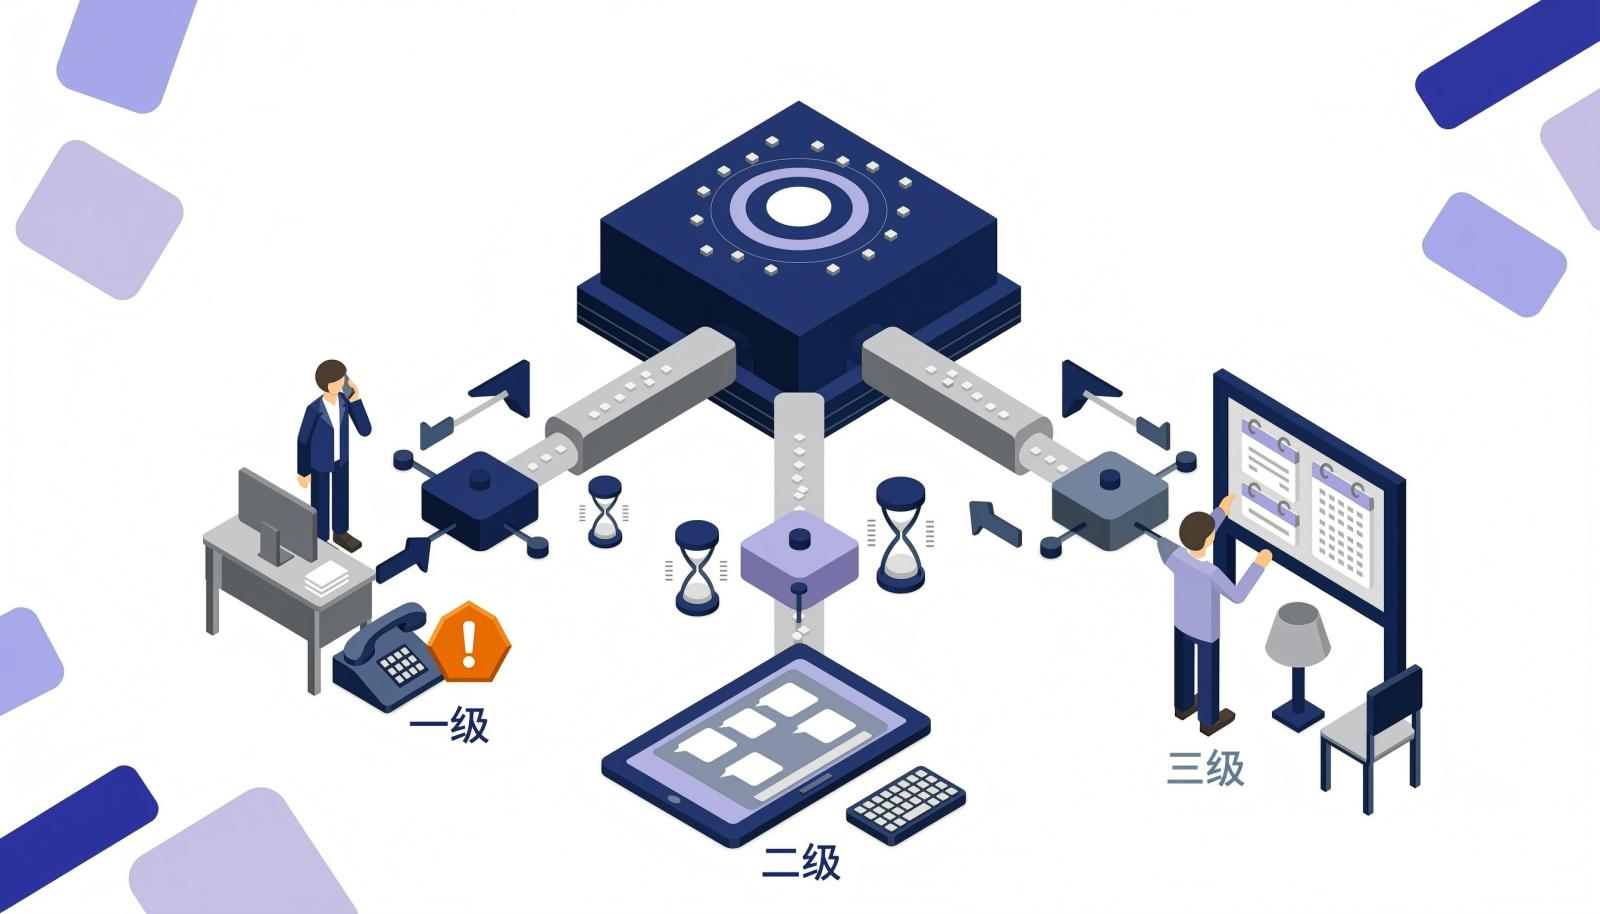
级别确定后,再按紧急程度选择渠道。下面是一份分级示例,时限按团队实际调整。
| 级别 | 判定条件 | 推送渠道 | 示例响应要求 |
|---|---|---|---|
| 一级 | 影响用户、收入或关键业务功能 | 电话或强提醒 | 15分钟内认领 |
| 二级 | 影响效率但可当天处理 | 工作群或站内消息 | 当日处理 |
| 三级 | 趋势偏离,无即时影响 | 看板标记或日报 | 周度复盘 |
渠道分级的价值是保护注意力。把大量告警放进同一渠道,重要消息容易和普通消息一起被忽略。三级告警也需要固定入口,避免只停留在日报里。
3. 聚合、静默与升级
同一根因的多条告警应合并,尽量只推根因告警;维护窗口和已知问题期间暂停通知,并设置到期时间;超时无人认领,自动升级到上一级。微软Learn的告警课程提醒,过度监控会让团队忽略或静音通知,真正的问题反而没人处理。与其增加规则,不如先合并同根因告警、设置静默和升级路径。当推送量超过处理能力,忽略往往成为常见结果。
四、验收:三个指标看效果
1. 看有效告警率
有效告警率可按产生实际处理动作的告警数除以总告警数计算,统计口径要固定。建议删除或重设长期没有带来动作的规则。 告警数量下降不一定是坏事,关键看漏报是否增加。
2. 看响应时长
从触发到认领的时间,反映推送路径是否顺畅。建议按级别分别统计,避免平均值掩盖一级告警的延迟。
3. 看漏报,并据此复盘
漏报情况用未触发告警但造成影响的事件数观察,可从故障复盘、客诉和人工巡检记录中收集。每月把这些事件与现有规则对照,删除无动作告警、合并同根因规则、调整长期接近阈值的规则。大促、渠道上线、口径调整前,重新核对阈值和数据新鲜度。
工具提供的是能力,规则仍要由团队维护。 如果团队还要把项目交付数据纳入看板,禅道项目管理软件提供统计视图与自定义报表,可汇总项目、任务、测试等数据;具体功能可参考统计报表说明。实际配置仍以团队业务为准。运营看板工具能否产生价值,很大程度上取决于规则是否有人持续维护。
五、常见问题
1. 大促或节假日要不要临时改阈值?
要,但建议新建带到期时间的临时规则,不要直接改原规则。工具支持到期时间时,活动结束自动失效;不支持时,要在活动结束后手动恢复,避免忘记。
2. 看板数据和业务系统对不上,先查什么?
先核对指标定义、统计时间和筛选条件是否一致;再核对数据同步时间与查看权限;最后查源系统。常见原因不是工具故障,而是口径或时间范围不同。
3. 阈值应该由业务定还是由技术定?
业务定异常标准和影响范围;数据团队定口径与计算方式;技术团队负责推送实现;上线前共同验收。只由一方定,容易出现规则可用但没人接手的情况。
文章标题 :运营看板工具的实时性与告警:刷新频率、阈值与推送怎么配 ,发布者 :项目管理研究院