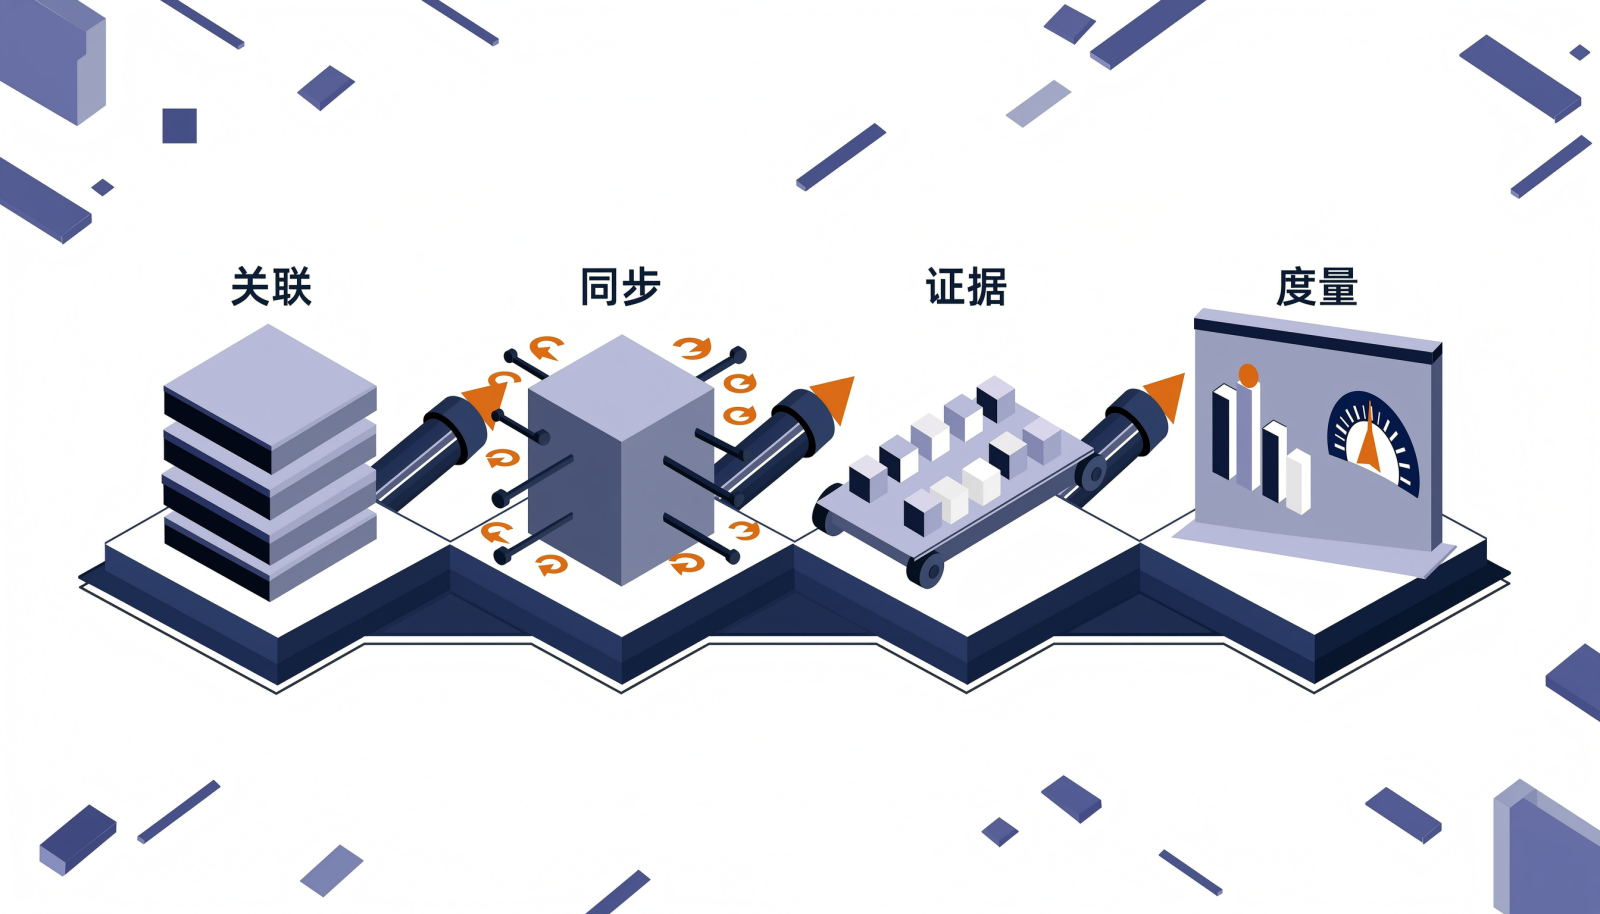
需求还停在进行中,代码已经合并上线,这种对不上的情况几乎每天都在发生。集成点指的是项目管理软件与Git仓库、CI/CD之间交换数据的接口位置。研发链路上的集成点分四类:代码关联、事件同步、证据沉淀、度量回流。四者存在先后依赖,前一类不稳,后一类的数据就不可信。
一、环境割裂的代价与集成的边界
1. 割裂出现在哪里
工作项看板记录计划状态,代码仓库记录变更事实,流水线记录构建与部署结果,三处各说一段。状态靠人工回填时,回填滞后于事实,越接近发布偏差越大。由此带来三类重复劳动:业务方逐个询问进度,测试需要反复确认版本与用例,运维需要重新梳理变更范围。排查一个线上问题时,提交、构建、制品的信息要跨系统手工拼接。
2. 集成做什么,不做什么
集成不改变研发流程,只做映射:代码侧的事件与产物,映射为管理侧的状态、评论、关联关系与度量数据。它成立的前提是两侧能识别同一个对象,也就是每次提交都能指向唯一的工作项。
集成的第一步不是接口对接,而是建立唯一标识。 标识缺失时,回写的数据无法归属到正确的工作项,看板与报表都会出现偏差。
二、四类集成点总览
四类集成点交换的数据、实现方式和解决的问题各不相同,先看整体。
| 集成点 | 交换的数据 | 常见实现方式 | 解决的问题 |
|---|---|---|---|
| 关联点 | 工作项编号、分支名、提交信息 | 命名与提交规范、服务端钩子校验 | 每次提交有明确归属 |
| 事件同步点 | 推送、分支、合并请求、流水线事件 | Webhook订阅、开放接口回调 | 状态随事实自动流转 |
| 证据沉淀点 | 构建号、测试结果、制品版本、扫描结果 | 流水线结果回写、制品库接口 | 质量与交付结果可查 |
| 度量回流点 | 变更前置时间、部署频率、变更失败率、恢复时长 | 事件数据采集与统计口径统一 | 效能可度量、可追溯 |
四类之间是固定依赖:关联点提供身份,事件同步点提供流转,证据沉淀点提供依据,度量回流点提供判断。关联不牢,后面三类都会失真。
三、集成点一:代码与工作项的关联
1. 三种关联载体
分支命名携带工作项编号,提交信息引用该编号,合并请求描述中声明关联关系,这三处是关联的落点。多数代码托管平台支持在合并请求描述或提交信息中写固定关键词声明关联,并在合并到默认分支时自动关闭对应议题;如果目标分支不是默认分支,这类关键词通常不生效。分支策略因此不能只按开发习惯来定。
2. 让关联可校验
只写在文档里的规范会逐渐松动。更稳的做法是在推送或合并时用服务端钩子校验编号是否存在、格式是否合规,不合规直接拦截。进入主干的每次提交都应能追溯到工作项,否则后续的证据沉淀与度量都会缺一块。
四、集成点二:事件与状态的自动同步
1. 回写链路的四个环节
事件产生,解析事件类型与目标工作项,按映射规则写入状态或评论,最后留下回写记录。实现方式通常是Webhook订阅、开放接口或流水线里的回调步骤。这里最需要控制的是权限:集成账号只读写指定项目,令牌定期轮换,回调校验来源签名,回写日志保留可查。
2. 先定映射规则,再谈自动化
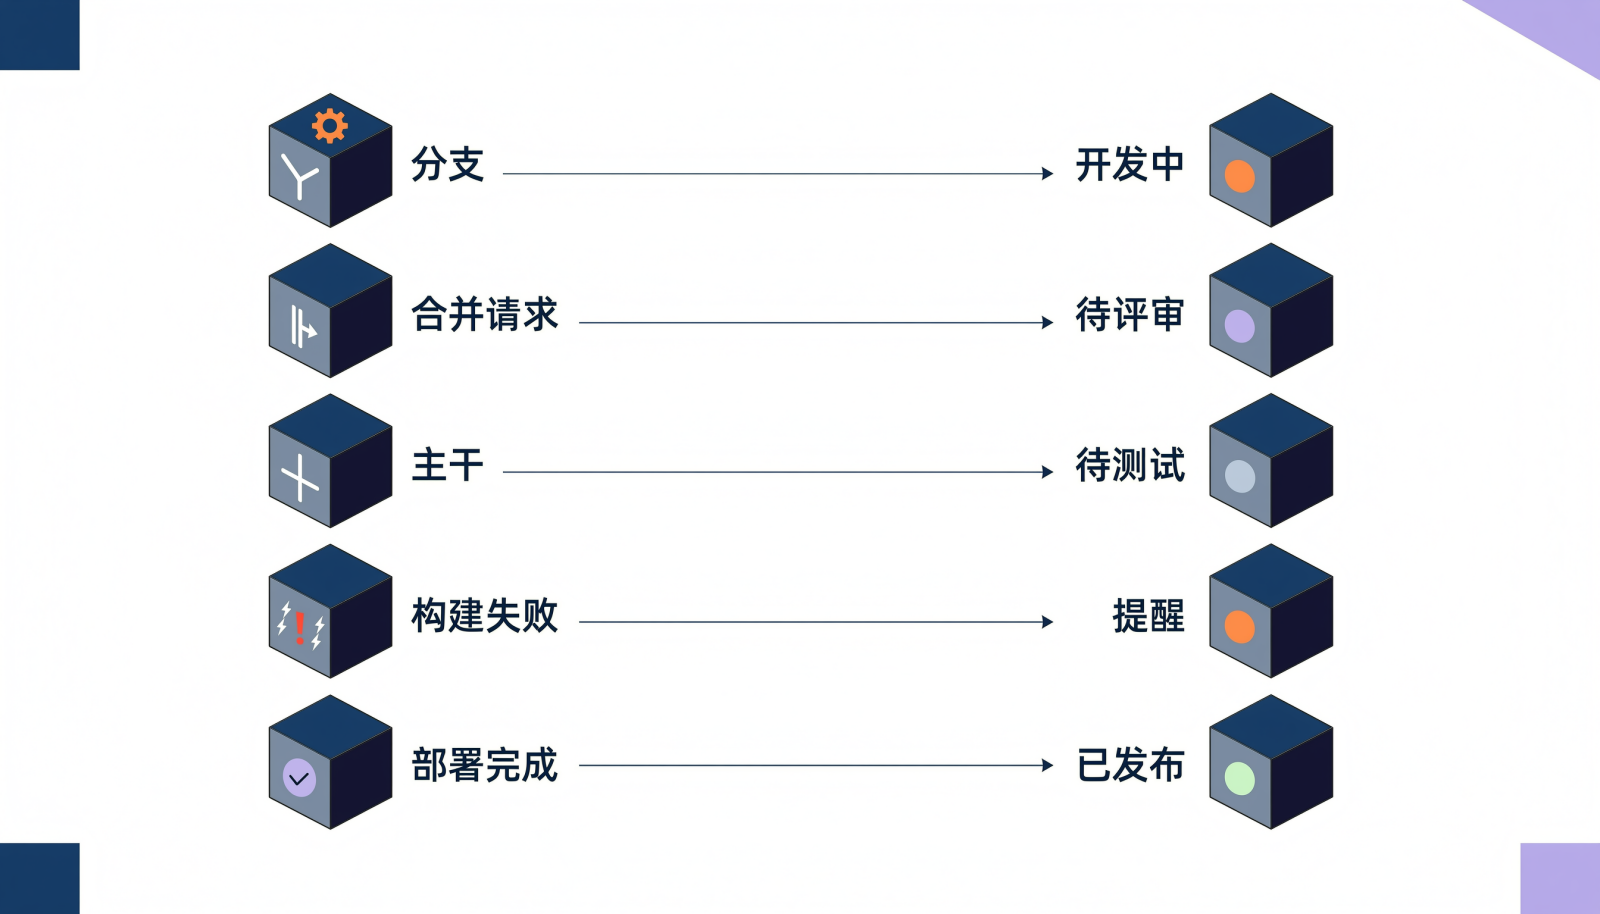
自动同步不是把所有事件都做成状态跳转,而是先明确哪类事件对应哪种管理动作。
| 代码侧事件 | 管理侧动作 | 注意点 |
|---|---|---|
| 创建分支 | 工作项状态置为开发中 | 一个工作项挂多个分支时需先约定 |
| 提交合并请求 | 状态置为待评审,并在工作项下留痕 | 合并请求不能替代评审流程 |
| 合并到主干 | 状态置为待测试 | 是否自动关闭由团队规则决定 |
| 流水线构建失败 | 在工作项下生成提醒或阻塞项 | 只提醒,不自动回退状态 |
| 部署完成 | 状态置为已发布,记录版本与环境 | 需绑定环境标识,避免相互覆盖 |
映射规则要覆盖三件事:哪些事件触发写入、写入什么状态、哪些情况不写入。规则缺失时,状态会随最后一次事件漂移,团队也会重新回到口头同步。
五、集成点三:流水线证据的沉淀
1. 回挂哪些证据
构建号与制品版本、自动化测试结果、覆盖率、代码扫描结果、部署环境与时间,这些数据在流水线里已经存在,只是通常留在日志中,需要按工作项回写。回写之后,测试拿到版本号即可看到本次构建执行了哪些用例、通过情况如何;排查线上问题时,也能从工作项直接定位到具体制品。
2. 门禁让证据成为约束
测试通过率、扫描高危项数量不达标时,阻断合并或发布。门禁的价值是把质量判定标准固定为统一规则,减少由个人判断带来的差异。
六、集成点四:度量与追溯的数据回流
1. 四项指标只认一个数据源
变更前置时间、部署频率、变更失败率、恢复时长这四项,需要从代码与流水线事件中自动采集,不靠人工填报。据Google Cloud与DORA团队发布的《2025年DevOps状态报告》(Google Cloud,2025),受访的近5000名技术从业者中,个人层面的产出提速并未同步改善端到端交付指标,报告把原因指向工具碎片化与流程不统一。
数据集中在单个环节时,跨环境的等待与返工不会自动减少,这也是度量必须回到代码与流水线事件的原因。
2. 双向追溯
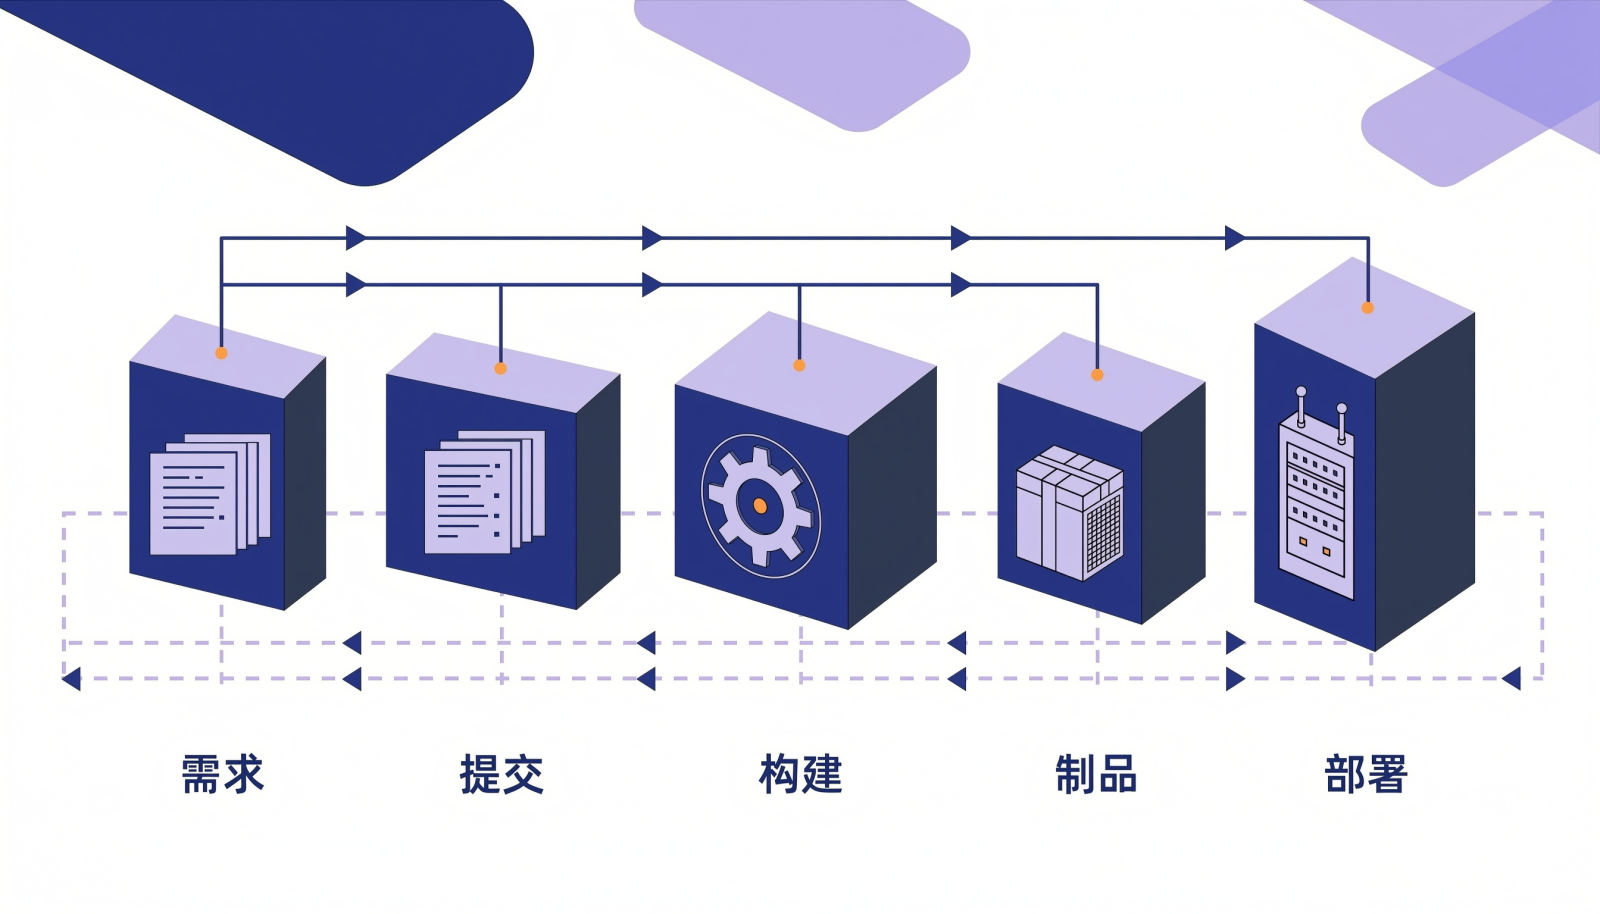
正向可以从需求或Bug出发,看到关联的提交、合并请求、构建、制品与部署环境;反向可以从线上异常出发,追溯到对应的制品、构建和工作项。追溯链的完整度由第三步的关联规则决定,规则越严,定位越快。
七、落地顺序与常见误区
1. 推进顺序
先做关联点,把命名与提交规范固定下来;再做事件同步,从单向、低频、低风险的回写开始;接着做证据沉淀,把构建与测试结果挂到工作项;最后做度量回流,统计口径以事件数据为准。每一步的可信度都建立在前一步的数据质量上。
2. 三个误区
先选平台再定规范,指望工具弥补标识缺失;状态全自动跳转且不留人工确认点,状态失真后成员会绕开系统;集成账号权限过大,把读写全项目的权限交给长期有效的令牌。
八、常见问题
一次提交可以关联多个工作项吗?
可以。主线保持单一下属关系,其余工作项用评论提及而非关闭关键词,否则度量归属会被拆散。
仓库改名或迁移后,已有关联会失效吗?
依赖编号的关联不受影响;依赖仓库路径、钩子配置或Webhook地址的关联需要同步更新。跨仓库共用编号空间时建议加前缀。
流水线频繁失败,工作项会不会被评论刷屏?
会。同一工作项、同一失败原因只保留一条记录并更新其状态,或按阶段合并提醒。
回写失败时按什么顺序排查?
先确认事件是否发出,再查签名与权限,然后确认编号能否解析,最后检查映射规则是否命中。
度量数据适合纳入个人考核吗?
不适合。个人口径容易诱发拆分提交、挑选简单任务等行为,团队级统计更接近交付事实。
文章标题 :项目管理软件怎么和 Git、CI/CD 打通:研发链路的四类集成点 ,发布者 :项目管理研究院