研发团队不缺数据,缺的是把数据变成判断的规则。迭代收尾时常见两种被动局面:测试资源压在低风险模块,高风险模块临近上线才暴露问题;进度看着正常,交付前一天才发现主线任务卡住。智能研发管理工具的价值,在于把历史记录转成可用的风险判断:Bug预测回答哪里可能出错,进度预警回答什么时候可能延期。下面按迭代排期、代码合入、迭代执行、版本发布四个节点展开。
一、分清两类信号:Bug预测与进度预警各管什么
1. Bug预测:回答哪里可能出错
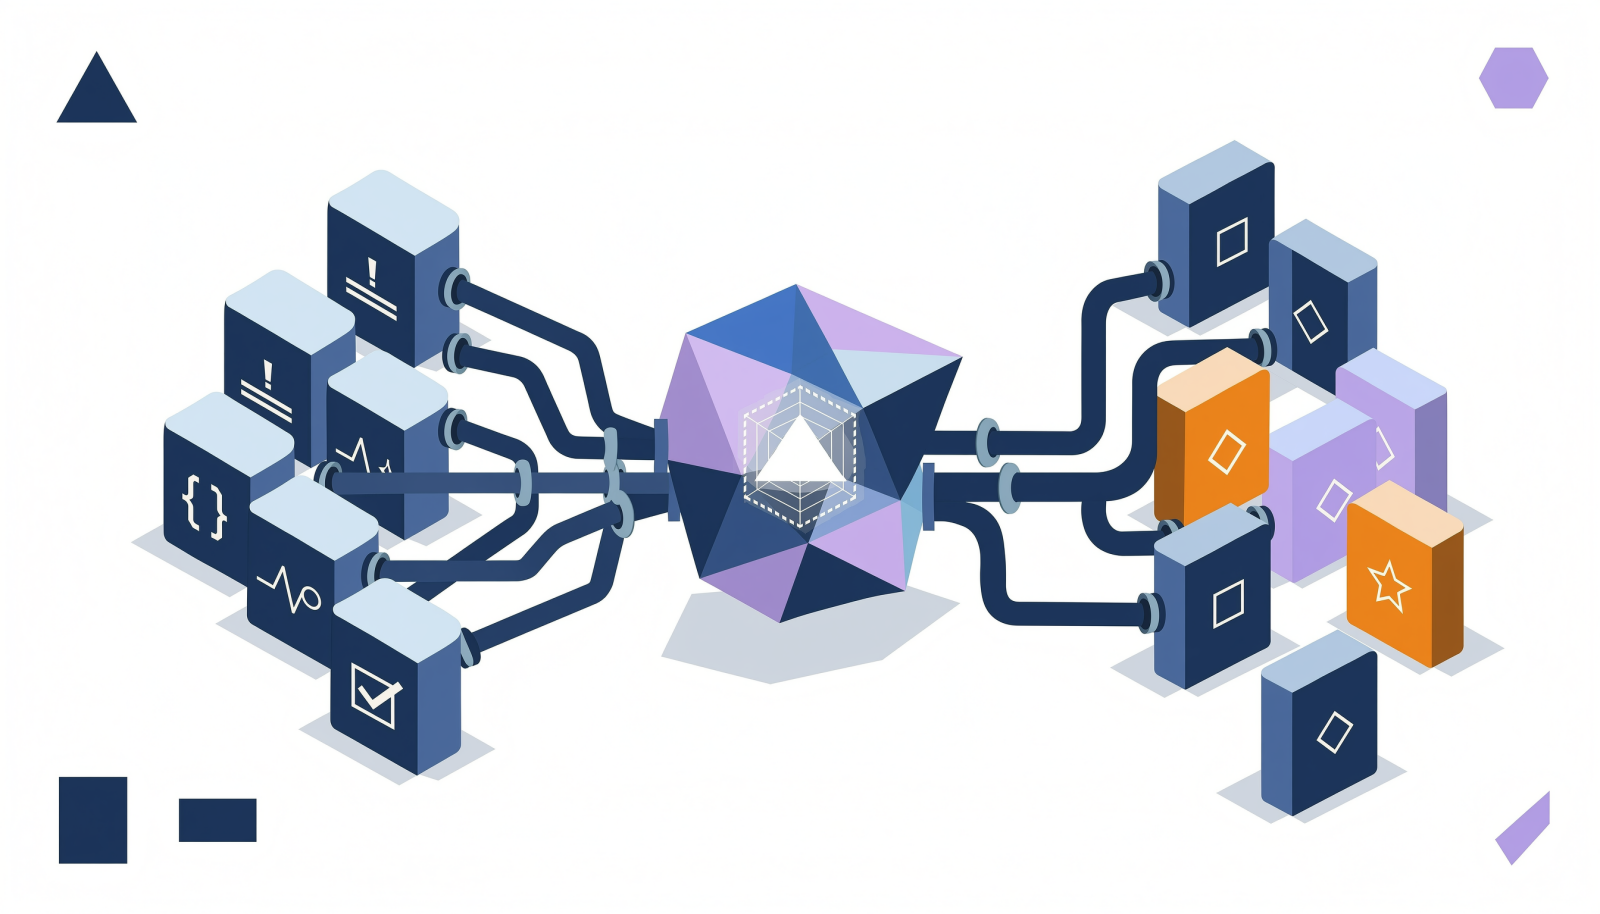
把历史数据转成打分规则,在问题发生前对模块或单次改动排序。常用输入包括代码改动行数与文件数、模块复杂度、修改频率、历史Bug记录、评审意见数量、测试覆盖情况;输出是一份风险排序清单。
评估时不能只看整体准确率:成熟项目中有问题的模块通常只占少数,模型把所有对象判为无风险也能拿到高分,因此要看它能否召回少数高风险对象,并权衡漏判与误报各自的成本。
2. 进度预警:回答什么时候可能延期
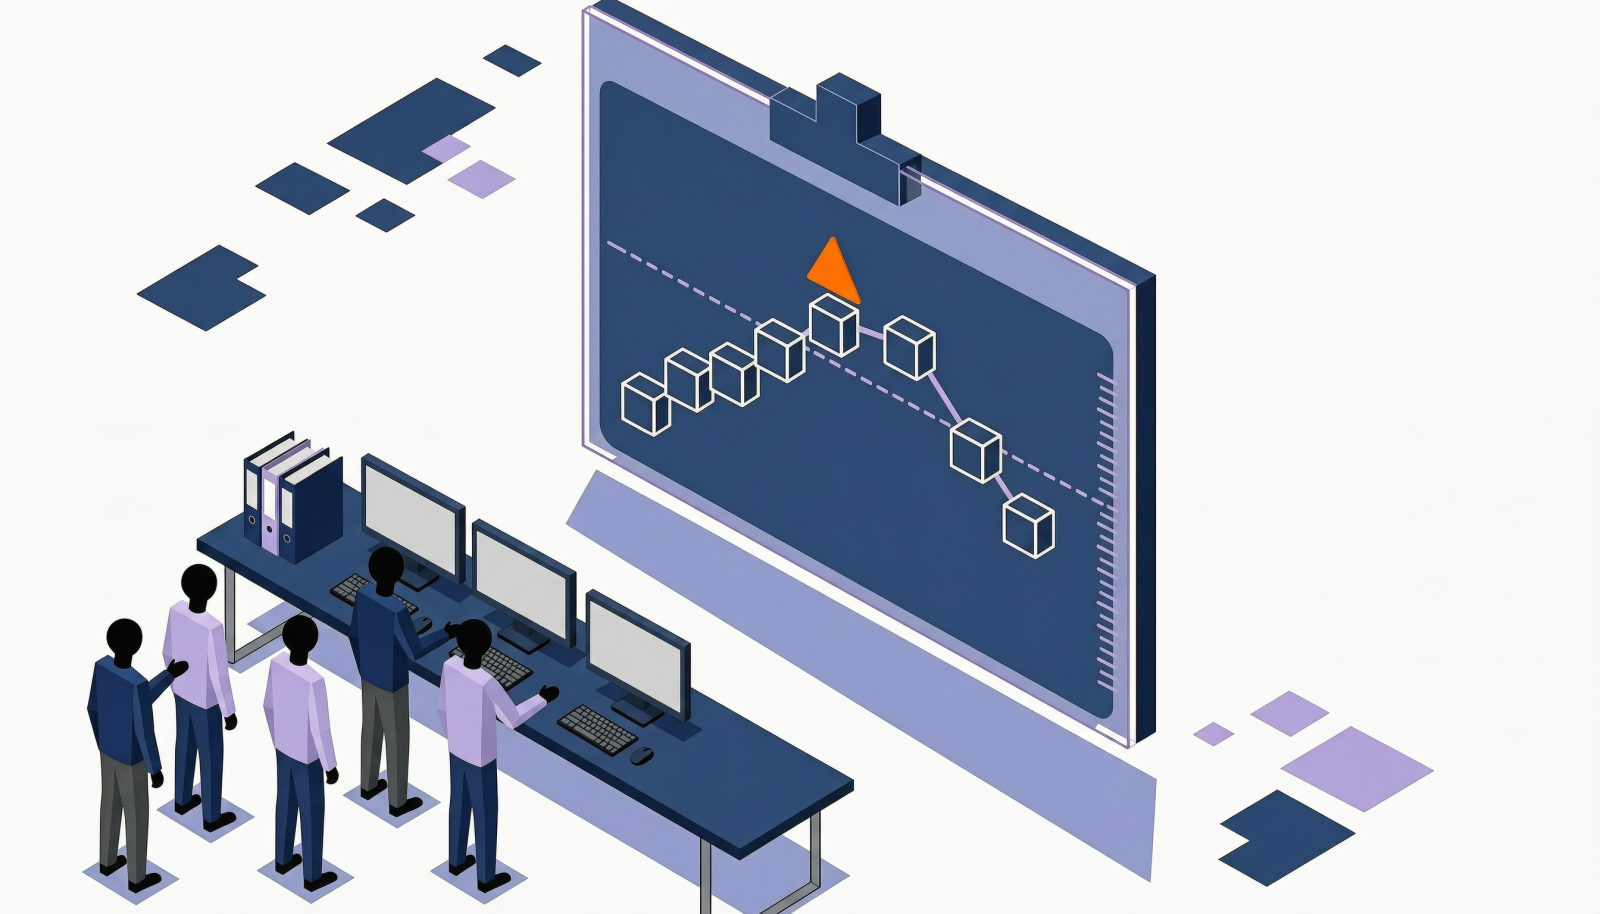
给关键指标一段历史基线,实际值偏离阈值即触发提示。常用三类口径:剩余工作量除以近期日均完成量,得到预计剩余天数,再与剩余迭代天数比较;单任务阻塞时长的常态上限;关键路径任务的计划日期推移。
基线口径要统一。行业常用的DORA指标体系把交付效率和交付稳定性分开观察,谷歌云发布的《2024年DevOps现状报告》在精英级判定中要求变更失败率低于5%、部署按需进行;这类口径可作参照,阈值仍要按团队自身历史水平校准。
3. 两类信号为什么要合起来看
返工会同时体现为Bug数量上升与任务停留时长增加,质量信号通常先于进度信号出现。资源不足表现为完成速度全面偏慢,返工则集中在少数模块反复出现,两者的处理方式分别是补充资源与收缩范围。
二、场景一:迭代排期阶段,把测试资源前置到高风险模块
1. 需要哪些数据
排期阶段用规则和统计基线即可,不必先上模型。至少三类数据要能对上:历史Bug记录(含模块归属、引入版本、修复时长)、代码改动记录、需求与模块的对应关系。三类数据打通后,可算出模块的历史Bug密度,作为风险排序的基础。这些数据往往分散在测试管理等环节,字段能否按模块对齐,比算法选型更影响结果。
2. 排期时怎么用
把下一迭代要改动的模块与历史风险分布比对,得到排序,再按排序分配测试人力与用例深度:高风险模块安排有经验的测试人员并追加专项验证,低风险模块走回归验证。风险分数只用于排序,不作为发布结论。
3. 怎么验证
迭代结束后统计高风险清单对实际发生Bug的覆盖率。覆盖率明显偏低时,先检查数据标签是否可靠,再调整特征,而不是继续调参。
三、场景二:代码合入阶段,用风险分值做评审预筛选
1. 颗粒度下沉到改动
模块级排序适合排期,合入阶段需要即时Bug预测:对单次提交或合并请求给出引入问题的概率,让评审深度与测试范围跟着风险走。
2. 阈值分层
阈值不宜一开始就设严,可按三档执行:低风险改动走常规流程,中风险要求指定人员复核,高风险改动补充针对性验证并留记录。阈值以误报率可接受为准,先宽松,再按实际结果逐步收紧。
3. 动作写进流程
预警只停在提示层,几次之后就会被忽略。把动作固化下来:高风险改动完成指定复核后才进入待发布状态;连续误报的规则需要回炉重设,否则会拖慢正常合入。
四、场景三:迭代进行中,用三个信号提前发现延期
1. 完成速度与剩余工作量的偏差
用剩余工作量除以近期日均完成量,得到预计剩余天数。预计剩余天数超过剩余迭代天数,就是最早出现的延期信号,此时调整范围的成本最低。
2. 阻塞任务的停留时长
阻塞任务数量参考价值有限,停留时长更能说明问题。给单任务阻塞时长设常态上限,超限即升级到阻塞方负责人,避免任务在无人跟进的状态下挂起一周以上。
3. 依赖与关键路径的滑动
跨团队依赖是延期的主要来源。项目进度按依赖关系统一维护,关键路径任务的计划日期一旦推移,同步重排下游团队排期,比等它自行恢复更稳妥。
三项信号的观察口径与处理动作如下。
| 预警信号 | 观察口径 | 触发后的动作 |
|---|---|---|
| 完成速度偏差 | 预计剩余天数超出剩余迭代天数 | 调整迭代范围或补充人力 |
| 阻塞停留时长 | 单任务阻塞时长超过团队常态上限 | 升级到阻塞方负责人并限期回复 |
| 关键路径滑动 | 关键路径任务的计划日期发生推移 | 重排下游依赖并同步关联团队 |
任意一项触发,都应在当天核实并给出结论。
五、场景四:版本发布前,质量与进度双门禁的联动判断
1. 两条门禁看什么
在智能研发管理工具中,发布前的判断通常落成两道门禁。质量门禁看Bug预测结果与未关闭Bug的分布,进度门禁看未完成项与依赖状态。两条门禁各自达标,发布才具备条件;只满足其中一条,风险容易被低估。
2. 三档处理
质量与进度均达标,正常发布;质量达标但进度滞后,缩减本次范围后再发布;质量未达标,先处理高风险模块,暂缓发布。判断标准前置后,发布决策不再依赖临时争论。
六、落地前需要补齐的三个前提
1. 数据基础
智能研发管理工具的预测能力,首先取决于记录质量。预测和预警都依赖连续、可追溯的过程数据,记录不完整的团队先补数据,再谈模型,否则风险排序没有参考价值。
2. 阈值校准
外部报告的数字只能当参照。中国信通院《中国DevOps/BizDevOps现状调查报告(2024)》提到,超八成组织已向BizDevOps演进或局部开展相关转型,流程贯通已是普遍方向;但基线仍要来自团队自己的历史数据,直接照搬外部数字通常失真。
3. 效果验证
上线后回看两项指标:预警对实际发生问题的覆盖率,以及误报占用的人力。衡量标准是减少的返工和提前发现的延期,而不是看板上的图形数量。
七、FAQ
问:阈值和基线该由谁定,多久校准一次?
由最熟悉交付节奏的技术负责人与测试负责人共同确定,落地后每个季度回看一次。调整过于频繁,团队会逐渐不把提示当回事。
问:度量数据要不要公开到团队和个人?
建议只公开聚合结果,个人明细留给本人复盘。数据一旦与个人评价直接挂钩,记录就会失真,任务被拆小、问题被延后登记,预警随之失去意义。
问:预测结果能替代人工评审和测试吗?
不能。预测做的是排序,把有限的评审精力引向高风险对象;改动是否正确,仍要靠人判断。把它当作优先级参考,比当作结论更合适。
问:预警天天提醒,会不会反而打扰团队?
会。建议按层级推送:日常偏差只放在看板,达到升级条件才通知责任人。通知密度超过团队的响应能力,预警就会迅速贬值。
文章标题 :智能研发管理工具怎么用:Bug预测与进度预警的四个落地场景 ,发布者 :项目管理研究院