版本发布前一周,前端在等接口,测试在等环境,上游团队临时改了字段名,联调群里同时冒出十几个问题。表面看是联调没排好,根子却在依赖没有被当成交付物管理。
跨团队依赖管理的核心,是把依赖变成有责任人、有契约、有时间锚点、有验收证据的交付物。
下面按五个环节展开:先分清依赖类型,再定接口契约,接着排联调节奏,随后管住联调现场,最后用验证和发布门禁确认闭环。开源敏捷管理平台里的需求、任务、用例、Bug和版本数据可以作为记录载体,但字段和规则要先设计好。
一、先分清四类依赖:别把所有等待都叫联调
依赖管理的第一步不是拉群,而是把等待拆开。跨团队依赖至少有四类,责任人和验证方式各不相同。
1. 接口契约依赖
一方提供API、消息或文件,另一方按约定消费。字段、协议、错误码、权限没有定稿时,排期再细也会返工。
2. 数据与状态依赖
上游的数据口径、状态机或主数据不稳定,下游就算接口通了也会算错。订单状态从三种变成五种,筛选和报表都要跟着改。
3. 环境与资源依赖
测试环境、联调环境、账号权限、第三方沙箱和专用设备都属于这一类。它常被当成运维事务,实际直接决定联调能否开始。
4. 发布窗口依赖
两个团队必须在同一窗口上线,或一方必须先于另一方发布。窗口依赖要用版本日历和回滚方案锁定,不能靠口头承诺。
四类依赖放在一张表里,排期时更容易看清责任。
依赖类型 | 典型信号 | 先确认什么 | 失约后果 |
|---|---|---|---|
接口契约 | 字段、协议、错误码未定 | 契约版本与责任人 | 联调反复返工 |
数据与状态 | 口径、状态机不稳定 | 数据字典与状态流转 | 结果算错、报表失真 |
环境与资源 | 环境排队、权限缺失 | 环境基线与账号 | 联调无法开始 |
发布窗口 | 上线日期不一致 | 版本日历与回滚方案 | 一方上线、一方回退 |
四类依赖的责任人通常不在同一个团队,必须分别指定提出方和承接方。依赖不是任务卡上的一句备注,而是一项有提出方、承接方、交付时间和验收标准的跨团队交付物。
二、接口怎么定:把口头约定变成可验证的契约
接口联调最常见的返工,不是代码写错,而是双方对接口是否可用的判断不同。提供方认为返回200就算通,调用方还在等一个稳定的错误码。
1. 先定边界,再定字段
先确认谁调用谁、同步还是异步、一次调用要完成什么业务动作,再讨论字段。边界不清,字段越多越容易错。
2. 契约至少写清六类信息
路径、方法、协议与超时;请求参数、类型、必填与校验规则;响应结构、分页、空值与错误码;认证、授权与租户隔离;幂等、重试与重复提交处理;版本策略、兼容期与下线时间。六类信息缺一类,联调就可能多一轮。
3. 用示例、Mock和契约测试把文档变成可执行物
OpenAPI规范把接口描述成机器可读的契约,人和工具都能据此确认能力边界。消费者驱动契约测试更进一步:调用方声明自己实际使用的请求和响应,提供方在流水线里验证是否仍然满足。接口文档写得再漂亮,没有示例、Mock和自动化验证,联调仍然要靠人猜。接口冻结的标志不是文档评审通过,而是双方能用同一份契约跑通正向、异常和权限三类用例。
三、联调怎么排:用依赖轨道压住关键路径
联调排期最常见的错误,是把它当成迭代最后几天的集中活动。接口没冻结、Mock没就绪、环境没基线,联调只能变成现场排错。规模化敏捷框架官方文档对敏捷发布火车的定义是通常由50至125人组成,这种规模下,依赖必须靠固定节奏和可见看板管理。开源敏捷管理平台可以把依赖项、契约版本、联调窗口和责任人放在同一条记录链上。
1. 先排契约冻结和Mock交付,再排联调会议
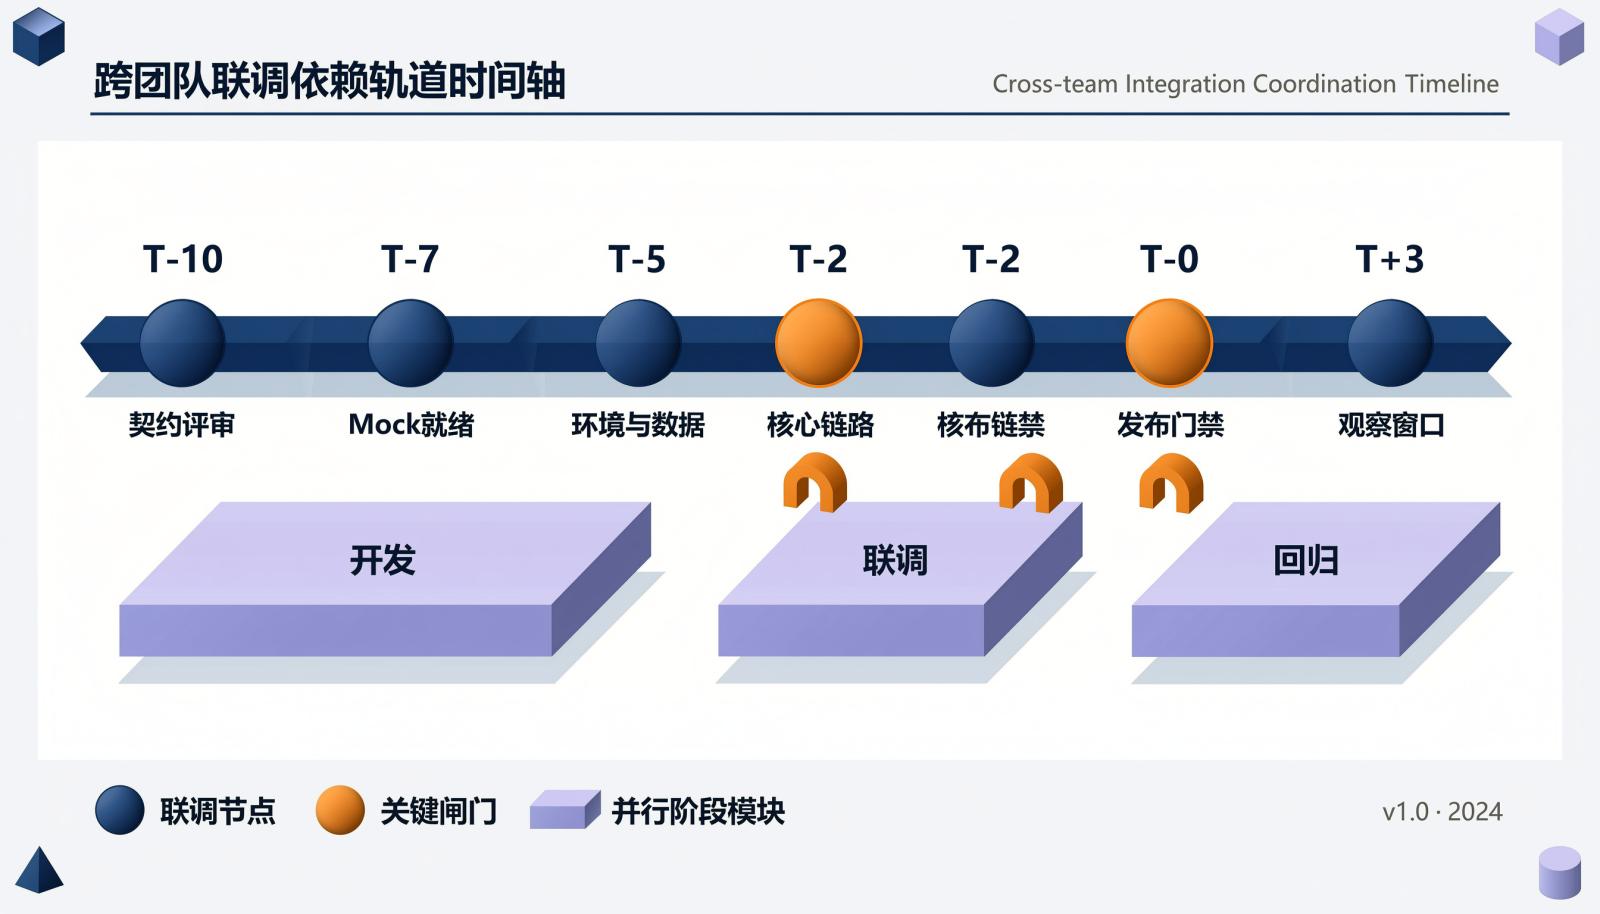
以两周迭代为例,契约评审放在迭代开始前后,Mock在联调前至少三个工作日可用。调用方拿到Mock就能先写业务和自动化用例,不必等提供方全部完成。
2. 把联调窗口放在迭代中段,预留回归和修复缓冲
联调窗口如果压到发布前两天,任何一次字段变更都会直接变成项目进度风险。更稳的做法是把核心链路联调放在迭代中段,最后两天只做回归、发布门禁和回滚演练。图1给出可复用的时间锚点,天数可按迭代长度调整。
3. 用准入和准出条件控制联调质量
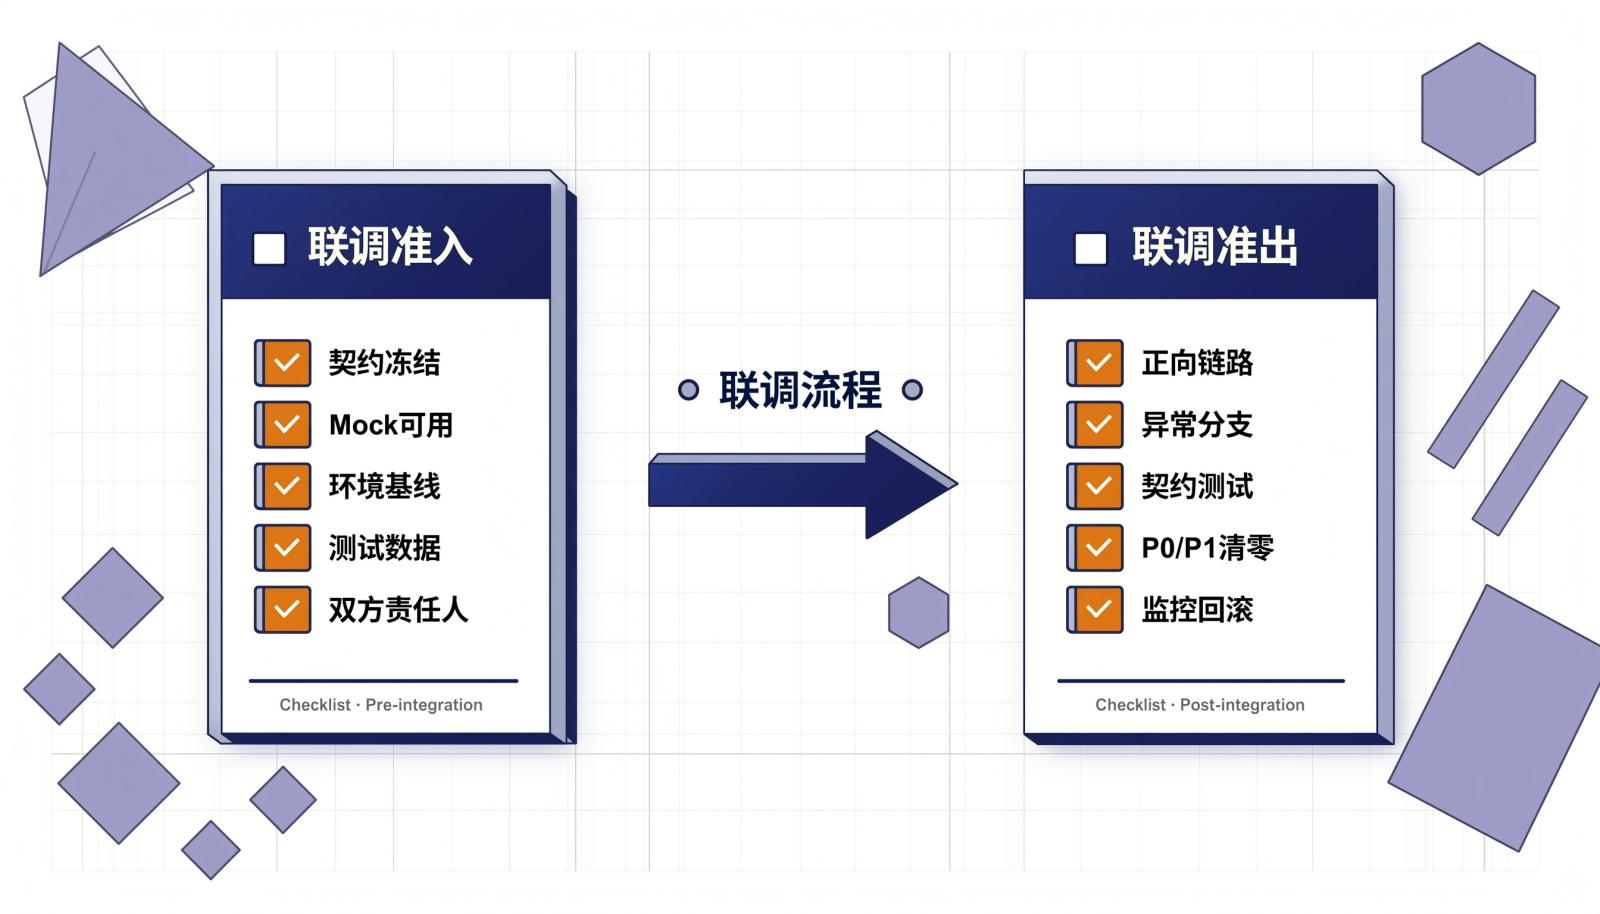
联调不是人到齐就开干。进入联调前,契约、Mock、环境、数据、双方责任人五项必须就绪;退出联调前,正向链路、异常分支、契约测试、P0/P1清零、监控回滚五项必须有证据。任何一项缺失,都应该记为未完成。图2把两组条件做成同一张检查表。
4. 用问题分级和升级阈值缩短阻塞时间
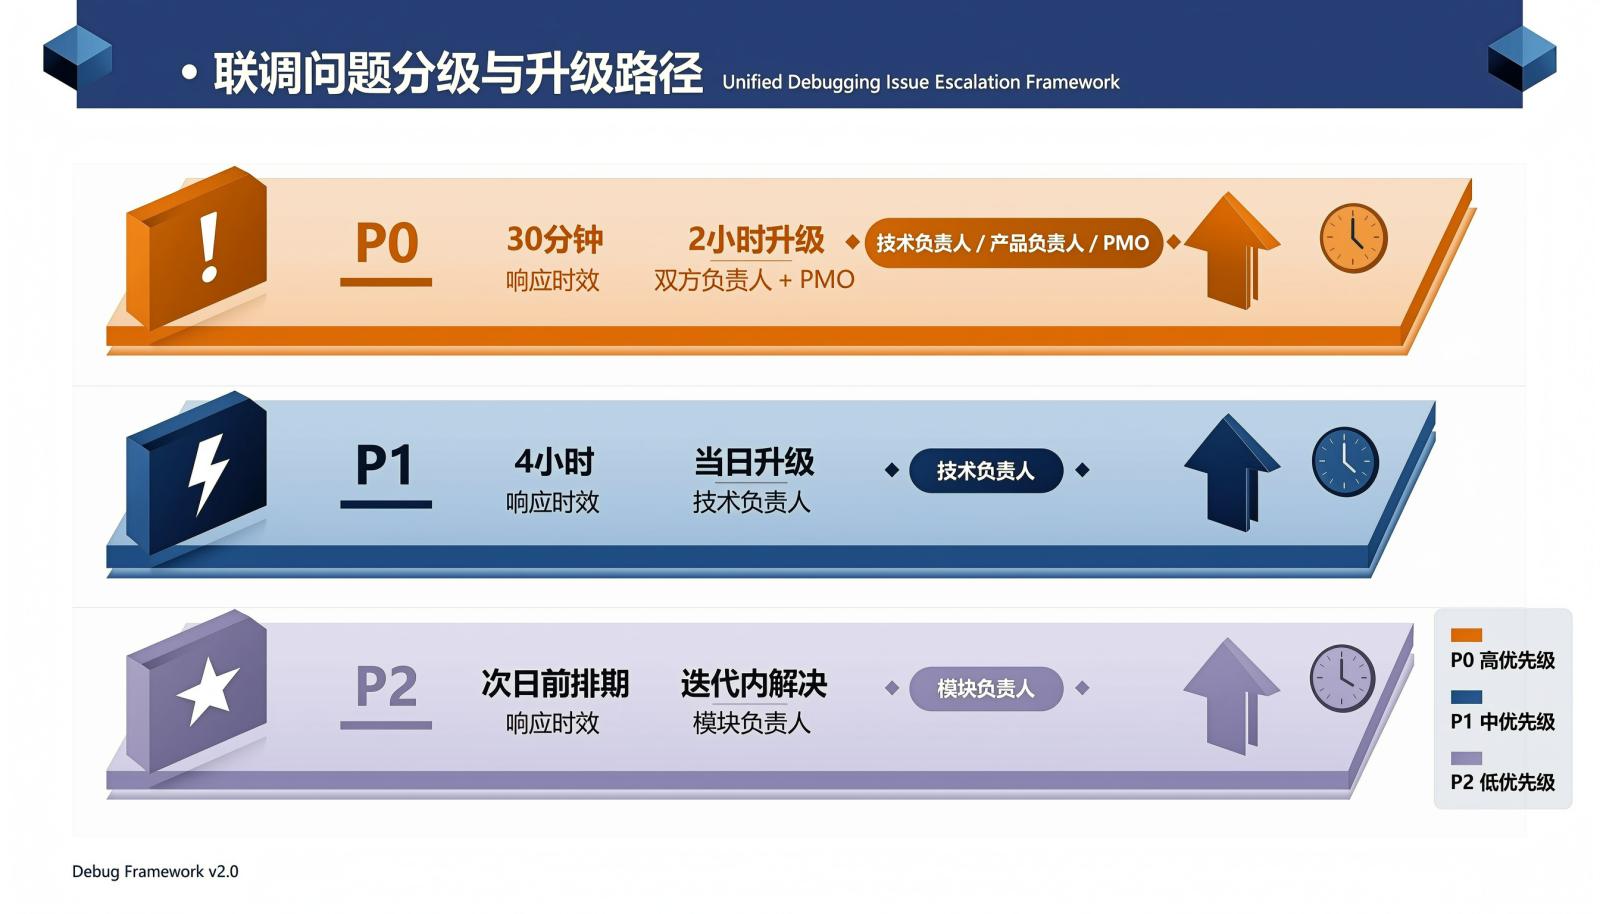
联调现场的问题要按影响面分级,而不是按谁的声音大排序。P0是核心链路完全阻断,P1是主要功能受损但有绕行方案,P2是次要问题。图3给出可套用的分级和升级路径,响应时间需双方提前确认。
联调不是迭代末尾的集中救火,而是一条从契约冻结开始、独立于迭代节奏的依赖轨道。
四、联调现场怎么控:环境、数据、问题三本账
联调现场失控,通常不是技术难题,而是三本账不清楚:环境版本、测试数据、问题归属。
1. 环境账:一套可复现的联调环境
记录每个依赖服务的版本、配置、账号权限和网络策略。谁改了环境、什么时候改的,要能查到。环境不稳定时,先复现再排查,不要直接怀疑代码。
2. 数据账:测试数据要能重复制造
联调数据要覆盖正常、边界、异常和权限四类场景,并明确种子数据、脱敏规则和清理方式。依赖上游真实数据时,要约定数据窗口和刷新频率,避免今天能测、明天不能测。
3. 问题账:一个入口、一个负责人、一个升级阈值
所有联调问题进入同一张问题清单,记录复现步骤、影响链路、责任人和期望解决时间。建议约定:P0问题30分钟内响应、2小时内升级到双方负责人和PMO;P1问题4小时内响应、当日升级到技术负责人;P2问题次日前排期,在迭代内解决。这些数字需要双方提前写进协作规则。联调现场最怕的不是Bug多,而是问题没有唯一入口、没有明确负责人、没有升级阈值。
五、怎么验证依赖真的闭环:从联调通过到可发布
联调通过只说明当下能通,不能说明下次变更不会断。依赖闭环需要三层验证。
1. 契约测试进流水线,防止字段回退
把调用方实际使用的请求和响应固化成契约测试,提供方每次提交都跑一遍。字段类型、必填项、错误码发生破坏性变更时,流水线直接拦截,而不是等到联调当天才发现。
2. 端到端冒烟只覆盖关键链路
冒烟测试用例不在多,而在覆盖跨团队主链路:登录与权限、核心业务提交、状态流转、异步消息、回滚路径。每条链路都要有明确的成功信号和失败定位信息。
3. 发布门禁看四项证据
发布前至少确认:契约验证通过、核心链路冒烟通过、P0/P1清零、监控与回滚就绪。四项缺一项,就不应该以联调已经通过为由放行。开源敏捷管理平台可以把需求、任务、用例、Bug和版本关联到同一条链路,但关联本身不产生质量,只有门禁规则被执行才产生质量。联调通过证明的是当下能通,契约测试和发布门禁证明的是以后不容易断。每次联调后复盘阻塞时长、返工原因和契约变更次数,用这些记录校准下一次排期。
资料来源:规模化敏捷框架官方文档,Agile Release Train,https://framework.scaledagile.com/agile-release-train,访问于2026年10月;OpenAPI Specification,https://spec.openapis.org/oas/latest.html;Martin Fowler,Contract Test,https://martinfowler.com/bliki/ContractTest.html。
六、常见问题
1. 跨团队依赖很多,先管哪几条?
先管三类:影响发布关键路径的、近期变更频繁的、责任人和验收标准不清的。其余的依赖可以进入周度评审,不必全部塞进每日站会。
2. 接口文档应该由谁维护?
提供方主责维护,调用方参与评审。联调后发生字段或错误码变更,必须回写契约并升版本,不能只在群里通知。
3. 联调环境不稳定,要不要各团队各自搭环境?
各自搭环境适合早期自测,不能替代统一联调环境。统一环境要有版本基线、配置清单和明确责任人,否则问题无法复现。
4. 联调问题应该由测试团队统一收口吗?
测试团队适合做问题入口和状态跟踪,但根因分析和修复责任仍在提供方与调用方。收口不等于兜底,否则测试会成为所有跨团队问题的瓶颈。
5. 联调通过后上线仍出问题,优先补哪类验证?
优先补容量与并发、权限与配置、外部依赖降级、回滚演练。联调通常只覆盖主流程,这四类验证更接近真实生产条件。
文章标题 :开源敏捷管理平台的跨团队依赖管理:接口与联调怎么排 ,发布者 :项目管理研究院