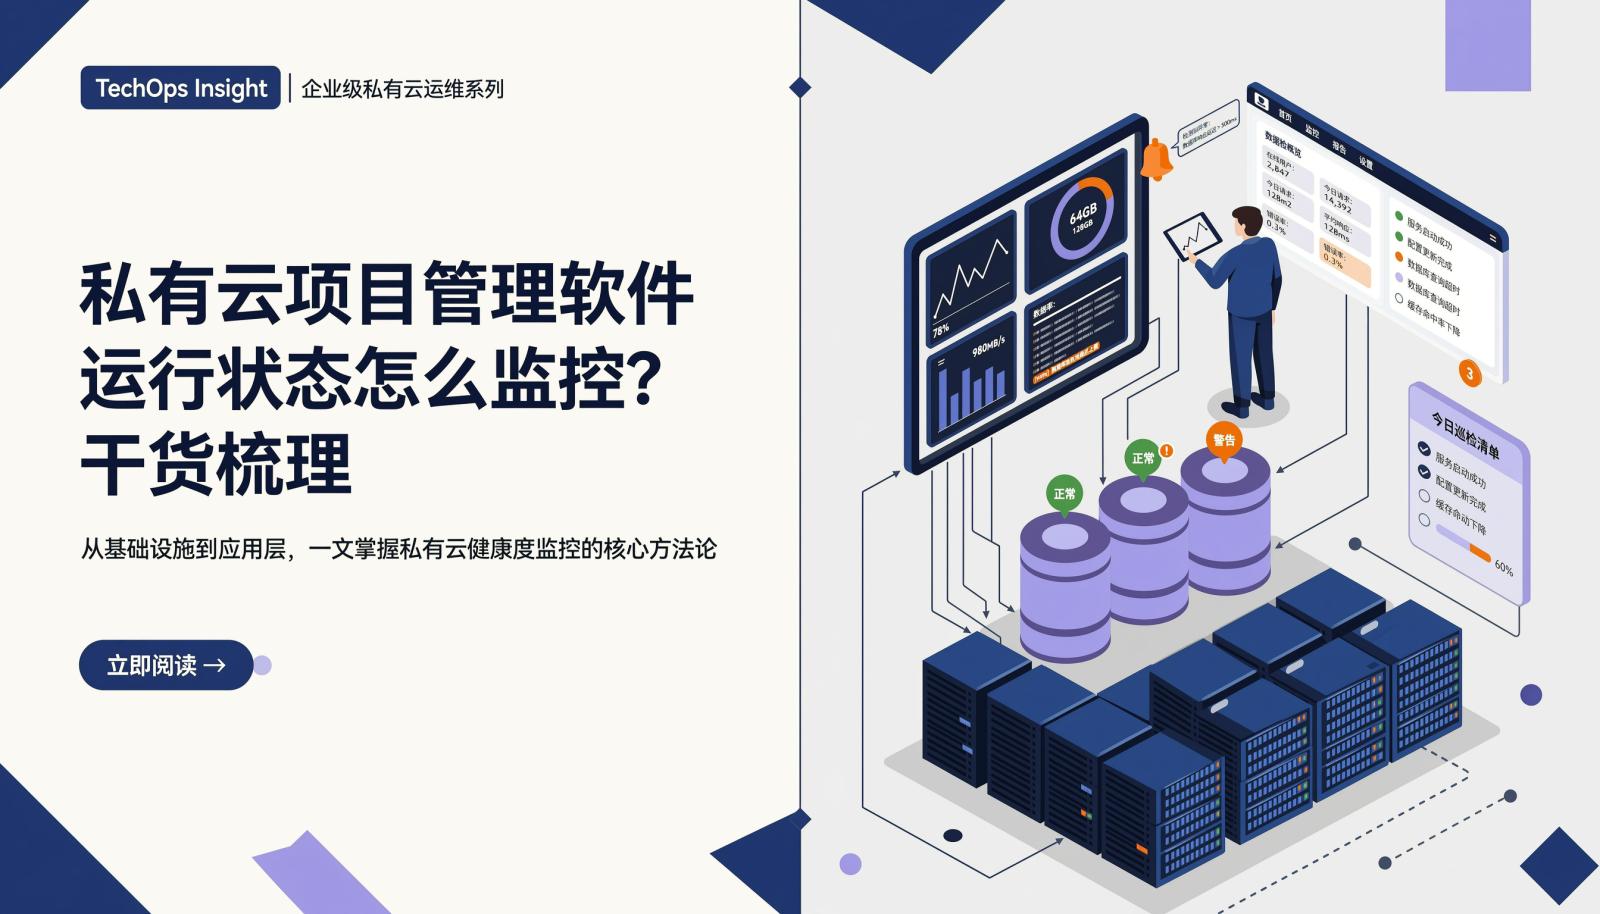
私有云项目管理软件部署在企业自己的机房或专有云环境里,服务器、数据库、应用和网络都由企业自己维护。系统能不能用、慢不慢、数据有没有备份,需要一套可验证的监控机制来回答。以禅道项目管理软件为例,下面按“监控什么、怎么采、怎么告警、怎么巡检、怎么排查”的顺序,梳理一套能落地的运行状态监控方法。
监控对象先分四层,别只盯服务器
只看 CPU 和内存,容易漏掉真正影响使用的环节。 私有云项目管理软件的运行状态,建议拆成四层来看。
| 层级 | 主要对象 | 关键指标 |
|---|---|---|
| 基础设施 | 宿主机、虚拟机、容器、网络 | CPU、内存、磁盘使用率与 inode、磁盘 I/O、网络延迟与丢包 |
| 数据层 | 数据库、附件存储、备份 | 连接使用率、慢查询、锁等待、缓冲池命中率、复制延迟、备份结果 |
| 应用层 | Web 服务、PHP-FPM、接口、计划任务 | 进程存活、请求错误率、P95 耗时、队列积压、任务执行结果 |
| 业务层 | 登录、需求/任务/Bug 操作、通知 | 登录成功率、关键页面可用性、核心操作成功率、通知送达 |
四层之间是依赖关系:数据库连接打满,页面会变慢;附件目录写满,上传会失败;计划任务停摆,备份和通知都会受影响。监控要把这些依赖串起来,而不是各看各的。
对中大型企业或规模化研发团队,建议每层先选 1 到 2 个能代表用户感受的指标,再逐步补充。项目管理系统的监控看板也应按这个结构组织,避免大屏堆满曲线却看不出问题。
指标怎么选:黄金信号打底,组件指标补位
分层之后是选指标。Google SRE 的四个黄金信号——延迟、流量、错误、饱和度——适合作为应用层的第一组指标,分别回答用户能不能用、系统忙不忙、错误多不多、资源是否接近上限。
落到私有云项目管理软件,建议先定义 5 到 8 个服务水平指标(SLI):首页与登录页可用性、登录成功率、核心页面 P95 耗时、接口错误率、数据库连接使用率、慢查询速率、磁盘使用率。P95 指 95% 的请求耗时不超过该值,比平均值更能反映用户体感。
组件指标用于定位,不替代业务指标。数据库重点看 Threads_connected 与 max_connections 的比值、Threads_running、慢查询、InnoDB 缓冲池命中率和锁等待;Web 层看 PHP-FPM 活跃进程与队列;存储看容量、inode 和写入延迟。
阈值不要照搬,先采集两周基线。 一个可用的起点如下,后续按业务高峰和复盘结果调整。
| 指标 | 说明 | 建议起点 |
|---|---|---|
| 连接使用率 | 当前连接数 / 最大连接数 | 70% 预警,85% 严重 |
| 慢查询速率 | 每秒超过 long_query_time 的查询数 | 连续 5 分钟高于基线即关注 |
| 缓冲池命中率 | InnoDB 缓存命中比例 | 低于 95% 排查 |
| 磁盘使用率 | 数据盘与附件盘 | 80% 预警,90% 严重 |
| 接口错误率 | 5xx 请求 / 总请求 | 5% 持续 5 分钟 |
采集方式:黑盒、白盒、日志三条线
指标确定后,要有数据来源。黑盒看“用户能不能访问”,白盒看“内部哪里出了问题”,日志负责解释“为什么”。
黑盒监控从外部模拟用户。用 Blackbox Exporter 对登录页、核心列表页和关键接口做 HTTP/HTTPS 探测,记录 probe_success、probe_duration_seconds 和证书剩余天数。探测点至少放两个:一个在服务器同网段,一个在办公网,避免把网络问题误判成应用故障。
白盒监控看内部状态。node_exporter 采集主机资源,mysqld_exporter 采集数据库,Nginx 开启 stub_status,PHP-FPM 开启 status 页面。容器化部署再加 cAdvisor,并统一 exporter 的实例标签,避免图表无法关联。
日志补充上下文:Web 访问日志看 5xx 和耗时,数据库慢日志看执行计划,应用日志看异常堆栈,计划任务日志看执行结果。禅道常见部署中,计划任务日志在 zentao/tmp/logs/ 下,具体以版本和安装目录为准;后台也能查看备份与定时任务的执行记录。
工具选一套主用即可:Prometheus + Grafana + Alertmanager,或 Zabbix,避免两套告警互相打架。
告警怎么配:先分级,再收敛
数据采上来,才谈得上告警。告警的目标是让人采取动作,不是把所有异常都推给值班人员。
建议按影响分三级:P1 是服务不可用或大面积登录失败,要求立即处理;P2 是性能明显下降或资源接近上限,按工作时段处理;P3 是证书临期、单次备份失败、慢查询增长等趋势问题,进入日常巡检。
每条告警至少包含四件事:现象、影响范围、看板链接、处理手册。规则要带持续时间,例如连续 5 分钟失败才触发,避免网络抖动造成误报。恢复后发送恢复通知,并与故障通知关联。
告警收敛可以合并同源告警、在维护窗口暂停通知、在上游故障时抑制下游告警。值班安排要有主备和升级路径,例如 15 分钟未响应升级到二线。
probe_success{job="zentao-http"} == 0
巡检机制:日检、周检、月检各看什么
告警解决即时发现问题,巡检解决长期稳定。Uptime Institute 2025 年宕机分析报告指出,近 40% 的组织过去三年经历过人为错误导致的重大宕机,其中 85% 与未按流程操作或流程设计不合理有关。巡检清单和操作手册,正是降低这类风险的抓手。
| 周期 | 重点检查 | 输出 |
|---|---|---|
| 每日 | 可用性、未恢复告警、备份结果、磁盘与 inode | 值班记录 |
| 每周 | 慢查询 Top 20、错误日志、容量趋势、计划任务 | 周报与待办 |
| 每月 | 恢复演练、权限复核、告警噪声、容量预测 | 改进清单 |
禅道管理员可以在后台的系统设置中查看备份与定时任务,在定时任务的执行记录里确认最近一次执行时间和状态。不同版本入口略有差异:18.2 之后备份与定时任务调整到“系统设置”下,更早版本在“数据”和“系统”菜单中。操作前先核对禅道使用手册。
恢复演练不能只看备份文件是否存在。 要在同版本环境中实际恢复一次,确认数据库、附件和配置文件都能用。备份失败一次就要处理,不要等到磁盘故障才检查。
出问题怎么定位:从用户症状倒推
巡检和告警都发现异常后,排查顺序决定恢复速度。先确认影响范围:全员还是部分人,内网还是外网,浏览器还是接口。范围不同,第一检查点也不同。
| 症状 | 先看什么 | 常见原因 |
|---|---|---|
| 页面打不开或 502 | 拨测结果、负载均衡、Web 与 PHP-FPM 进程 | 进程退出、端口不通、上游超时 |
| 能打开但很慢 | P95 耗时、数据库连接与慢查询、磁盘 I/O | 慢 SQL、锁等待、磁盘瓶颈 |
| 登录失败 | 登录接口状态码、认证服务、数据库 | 连接池耗尽、账号锁定、会话配置 |
| 附件上传失败 | 附件目录容量与权限、inode | 磁盘写满、权限变化 |
| 备份或通知不执行 | 计划任务日志、执行记录、系统 crontab | 任务未触发、进程退出、配置错误 |
定位时先恢复服务,再找根因。 数据库连接打满,可以先确认是否有异常长事务;磁盘写满,先清理可安全删除的日志和临时文件,不要直接删附件。需要恢复备份时,必须准备同版本环境,避免恢复后再次升级。
每次故障后做一次简短复盘:触发信号是什么,哪条告警起了作用,哪一步最耗时,手册是否需要修改。输出要落到具体改动,而不是只写“加强监控”。
落地节奏:两周搭起最小闭环
把上面的动作排进节奏,才容易坚持。如果从零开始,不必一次做全。
第一周盘点资产和依赖,确定 5 到 8 个核心 SLI,部署 Blackbox Exporter 和 node_exporter,先让登录页、核心页面、主机资源和数据库连接可见。第二周补数据库、Web 和存储指标,配置 P1/P2 告警,确定值班人和升级路径,写出三条最常见的处理手册。
第三到第四周再补日志聚合、容量基线、月度巡检和恢复演练。首轮目标可以设为:5 分钟内发现服务不可用,15 分钟内定位到层,30 分钟内恢复或切换。这个目标要按团队规模和系统架构调整,不是承诺值。
私有云项目管理软件的监控,价值不是多一块大屏,而是让问题在用户投诉前暴露。 准备部署或扩容时,可以先从私有化安装和环境清单开始,把监控项与部署架构一起规划。
参考资料:
- Uptime Institute, Annual Outage Analysis 2025, https://uptimeinstitute.com/about-ui/press-releases/uptime-announces-annual-outage-analysis-report-2025
- 禅道,备份禅道,https://www.zentao.net/book/zentaopms/42.html
- 阿里云,MySQL 数据库监控接入,https://help.aliyun.com/zh/cms/cloudmonitor-2-0/integrate-apsaradb-rds-for-mysql
文章标题 :私有云项目管理软件运行状态怎么监控?干货梳理 ,发布者 :项目管理研究院