值班时被同一类告警反复打断,团队会从少看、不看,走到直接关闭通知。效能分析工具的异常告警一旦误报过多,消耗的不是告警额度,而是团队对数据的信任。本文先说明误报如何侵蚀可信度,再给出诊断顺序,随后介绍三个治理动作,最后用四个信号验证效果。
一、误报如何削弱告警的可信度
1. 可行动告警的判断标准
只有明确指出发生了什么、影响谁、下一步做什么的告警才值得响应。可行动率,即真正促成动作的告警占比,是衡量告警价值的关键。
2. 过度提醒会让人逐步忽略
告警越多,团队越倾向忽略,最终静音通知或关闭看板。告警疲劳正是对重复刺激的钝化。一项2017年发表、覆盖112名临床医生和126万余条提醒记录的研究显示,每次就诊中每多收到一条提醒,接受概率下降约30%,重复提醒占比每上升5个百分点再下降约10%(美国国立医学图书馆PMC数据库,PMC5387195)。重复且低价值的提醒,会让人逐步降低响应意愿。
3. 误报的三种主要来源
误报主要来自阈值过窄、口径不一和重复通知,三者叠加会让告警持续增多。
二、先定位问题层级:规则、口径还是通知链路
1. 用症状表区分问题层级
先不要急着调阈值。把最近两周的告警按症状归类,比逐条修改更有效。
| 症状 | 更可能的原因 | 验证信号 | 优先动作 |
|---|---|---|---|
| 同一指标每天固定时段触发 | 阈值没有考虑业务节律 | 触发时间高度集中 | 改为同比或移动基线 |
| 告警说异常,但没人知道要做什么 | 规则缺少动作与责任人 | 告警描述只有指标名 | 补充影响对象与处理建议 |
| 两个看板对同一指标结论相反 | 口径或数据源不一致 | 定义、时间窗不同 | 先统一口径再谈告警 |
| 一次发布后收到十几条告警 | 缺少聚合与根因关联 | 告警集中在同一服务 | 按服务与时间窗合并 |
| 告警关闭后很快再次触发 | 没有恢复条件或抑制窗口 | 反复开关 | 增加持续时间与恢复阈值 |
这张表不是标准答案,而是把讨论从哪条告警更准,拉回到哪一层出了问题。先确认症状,再决定改规则、口径还是通知链路。
2. 核验指标口径与数据延迟
效能分析工具的数据通常来自需求、任务、代码、测试和发布多个环节。交付周期、吞吐量、平均恢复时间的定义若不一致,异常告警就会把口径差异误判成业务异常;数据同步延迟也可能被当成实时异常。统一研发效能度量的定义、时间窗和数据源,是后续治理的前提。
3. 规则设计与通知链路的检查项
规则层面看三件事:是否设置持续时间、是否区分严重程度、是否有恢复条件。通知层面看是否把同一根因拆给多个群、多个角色。规则和通知同时失控时,团队收到的不是信息,而是重复劳动。
三、降低误报的三个治理动作
1. 按影响范围和紧急程度重做分级
按影响范围和紧急程度把告警分成四类,而不是按指标名字排序。影响多个团队、已经影响用户的问题,立即处理;只影响单个团队、可以当天处理的问题,进入当日队列;需要观察但不影响交付的,留在工作时间内处理;没有明确动作的,只记录,不通知。分级的目的不是增加层级,而是让每个告警都有明确的去向。看板管理的重点也在于先让告警有明确去向,再谈展示多少指标。
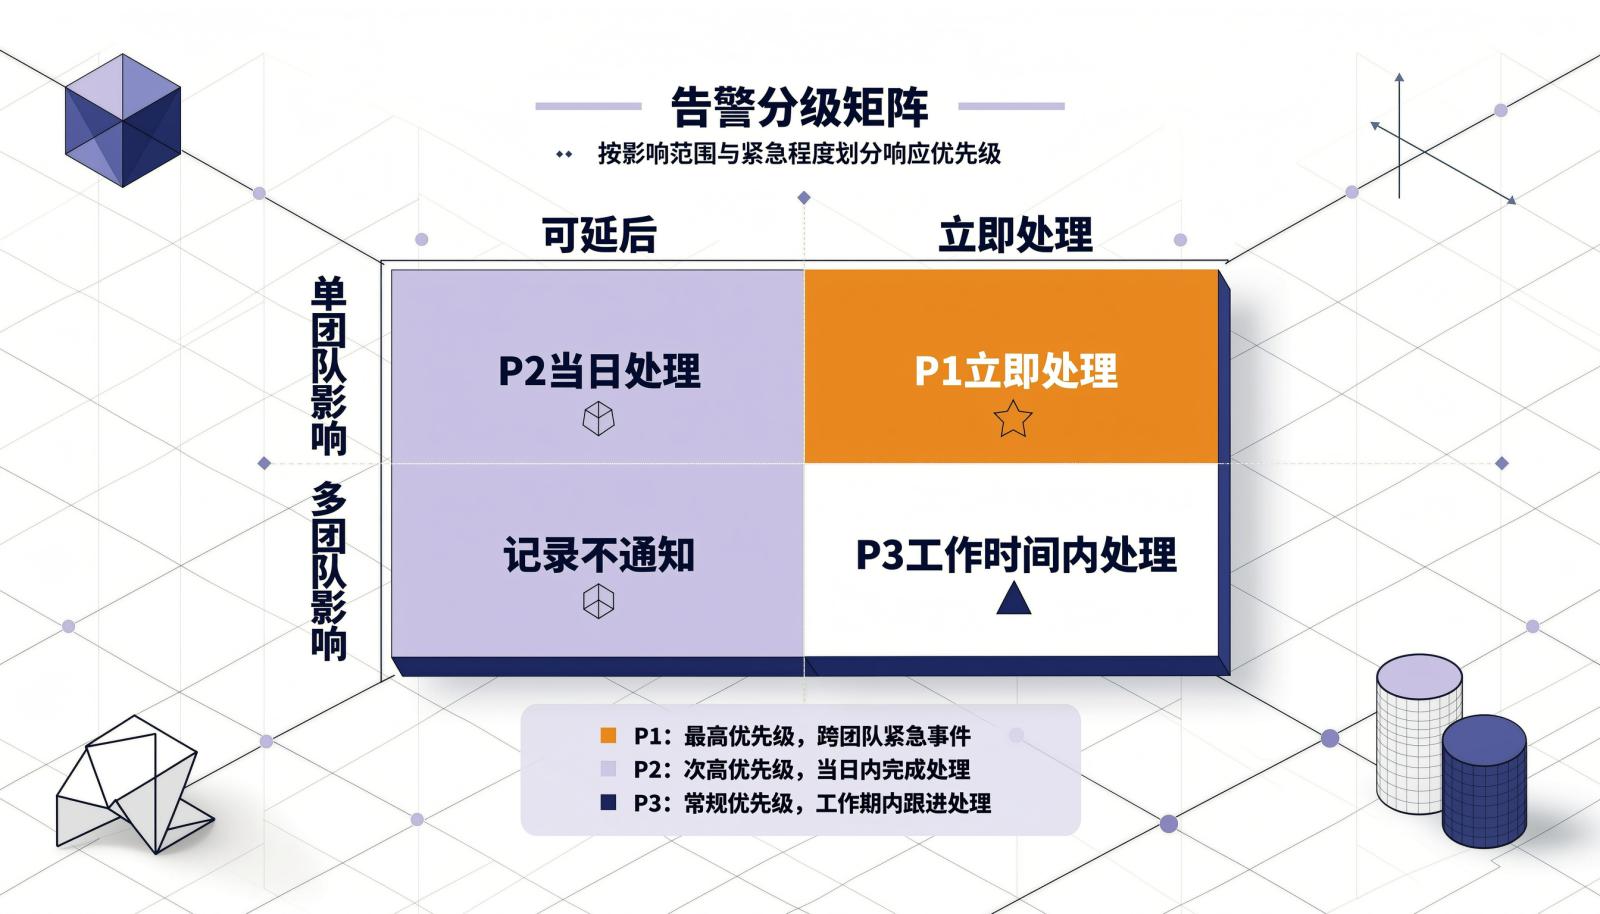
分级之后,通知渠道变少:团队知道哪个通道必须立即响应,哪个可以集中处理,注意力才不会被打散。
2. 聚合、去重与时间窗抑制
同一个根因往往会触发多条告警。聚合时先按服务或依赖关系归并,再在一个时间窗内只保留一条主告警,其余作为上下文附在下面。聚合的目标不是减少告警数量,而是让一条通知承载完整上下文。
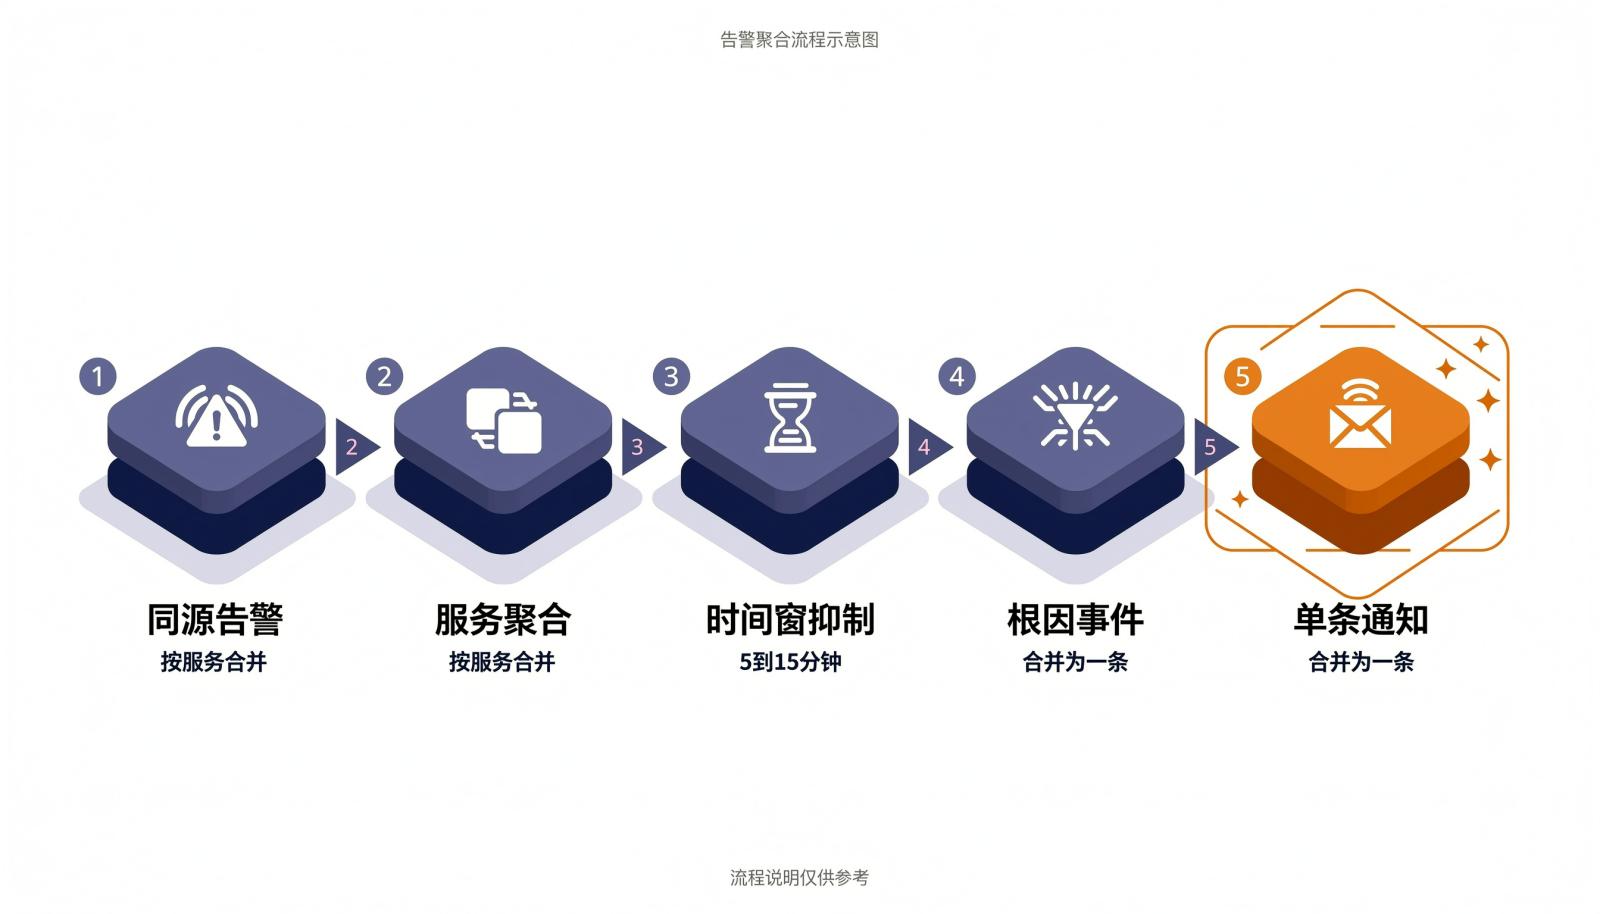
聚合之后,团队收到的是根因事件,而不是十几个症状。要避免为了压低数量而合并成模糊通知;合并后仍保留影响对象、开始时间、当前状态和下一步动作。
3. 以周为单位建立误报治理闭环
误报不会一次修完。更可持续的做法是固定一个短周期:定期抽最近触发最多的告警,逐条标记它属于真异常、口径问题、规则问题还是重复通知,只改一类,观察后再复盘。改动前留旧规则,改动后先小范围灰度,确认没有漏报再全量。
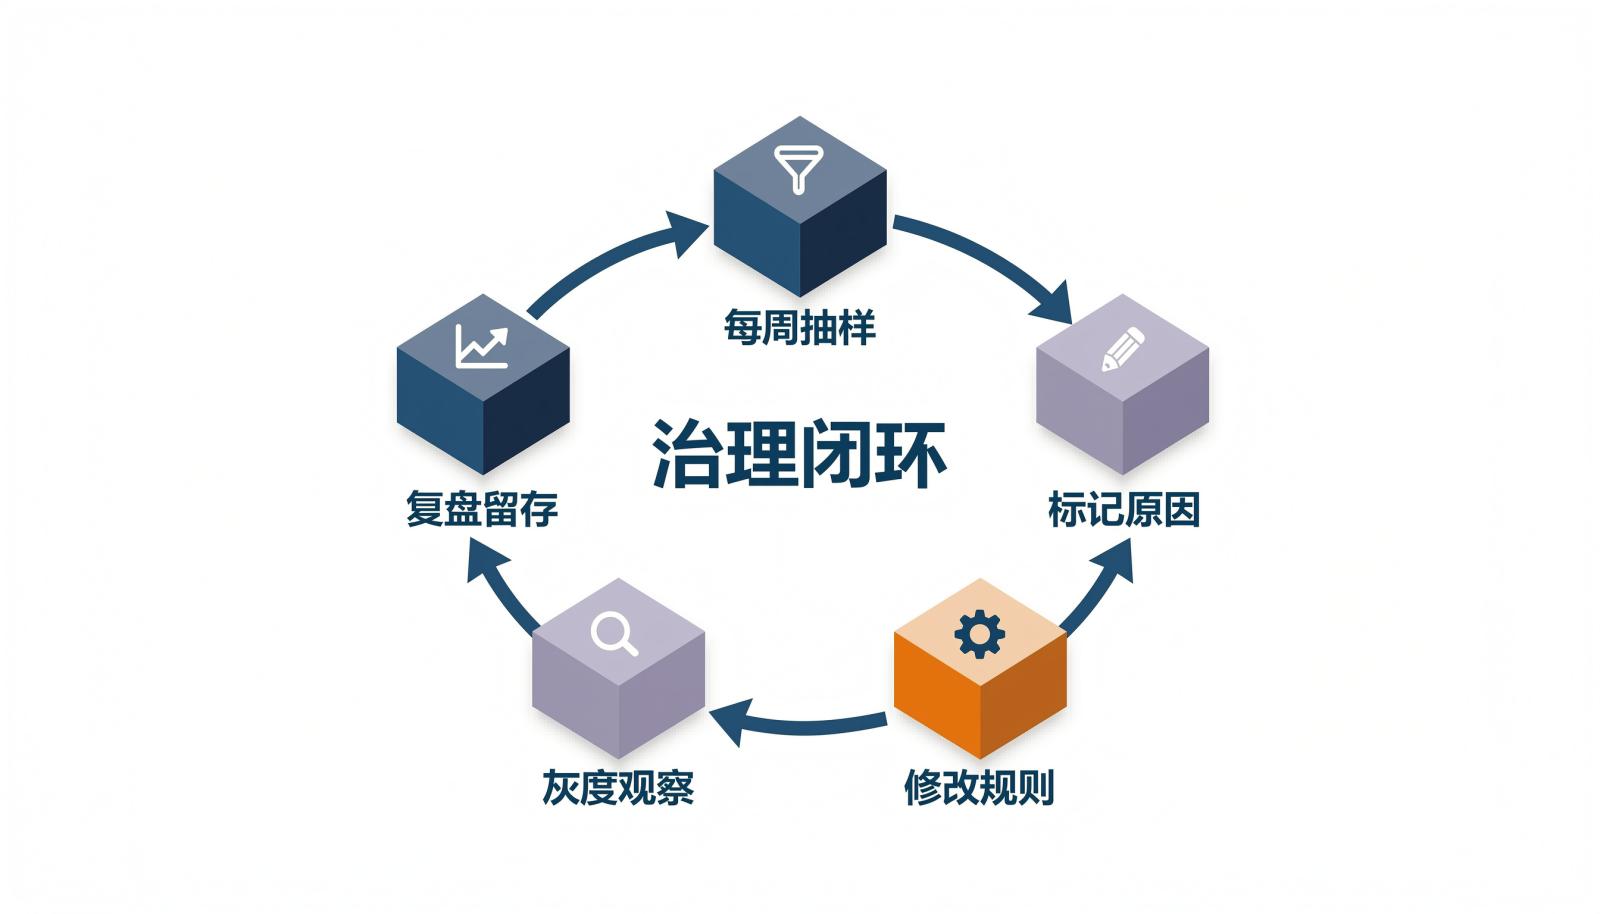
这个闭环的关键不是开会,而是留下记录:哪条告警被判定为误报,原因是什么,改了哪个条件,改完后真实异常有没有被漏掉。没有记录的治理,下一次还会在同一个地方重复讨论。
四、验证治理效果的四个信号
1. 可行动率
可行动率是最直接的信号。统计一段时间内真正促成动作的告警比例,观察四周后是否上升,团队是否愿意重新打开看板。
2. 重复告警占比
重复告警占比反映聚合是否有效。按服务、按根因、按时间窗统计重复触发的比例,下降说明聚合和抑制起了作用;如果比例没降,说明规则只是被静音,没有被真正整理。
3. 平均确认时长
平均确认时长指从告警发出到有人确认的时间。它下降,通常意味着告警描述更清楚、责任人更明确;它上升,则可能是团队已经不再相信这个通道。
4. 静音与关闭记录
静音不是问题,无法解释的静音才是问题。记录每次静音的告警、原因和恢复时间,能区分两类情况:一类是团队主动管理噪音,另一类是团队已经放弃。后者需要回到规则和口径重新处理。
五、误报治理中的常见问题
1. 误报率降到多少才算正常
没有统一数值。先建立团队基线,再看可行动率、重复告警占比和平均确认时长是否持续改善。
2. 看板长期无人使用,先删指标还是先改告警
先看原因:告警噪音先改告警,指标与任务无关先删指标。顺序反了会误删有效信号。
3. 团队没有专职运维,如何控制告警数量
设一名兼职告警负责人,定期复盘;新增告警必须写清动作和责任人,默认只记录不通知。
4. 告警应该发给所有人还是只发负责人
只发负责人,需要时再升级。发给所有人会把通知变成背景噪音,反而降低响应。
5. 治理一段时间后误报又反弹,怎么办
说明规则没有沉淀。回到定期复盘,把修改后的规则和原因写进文档,避免重复调整。
文章标题 :效能分析工具的异常告警,误报一多,团队就会把看板关掉 ,发布者 :项目管理研究院