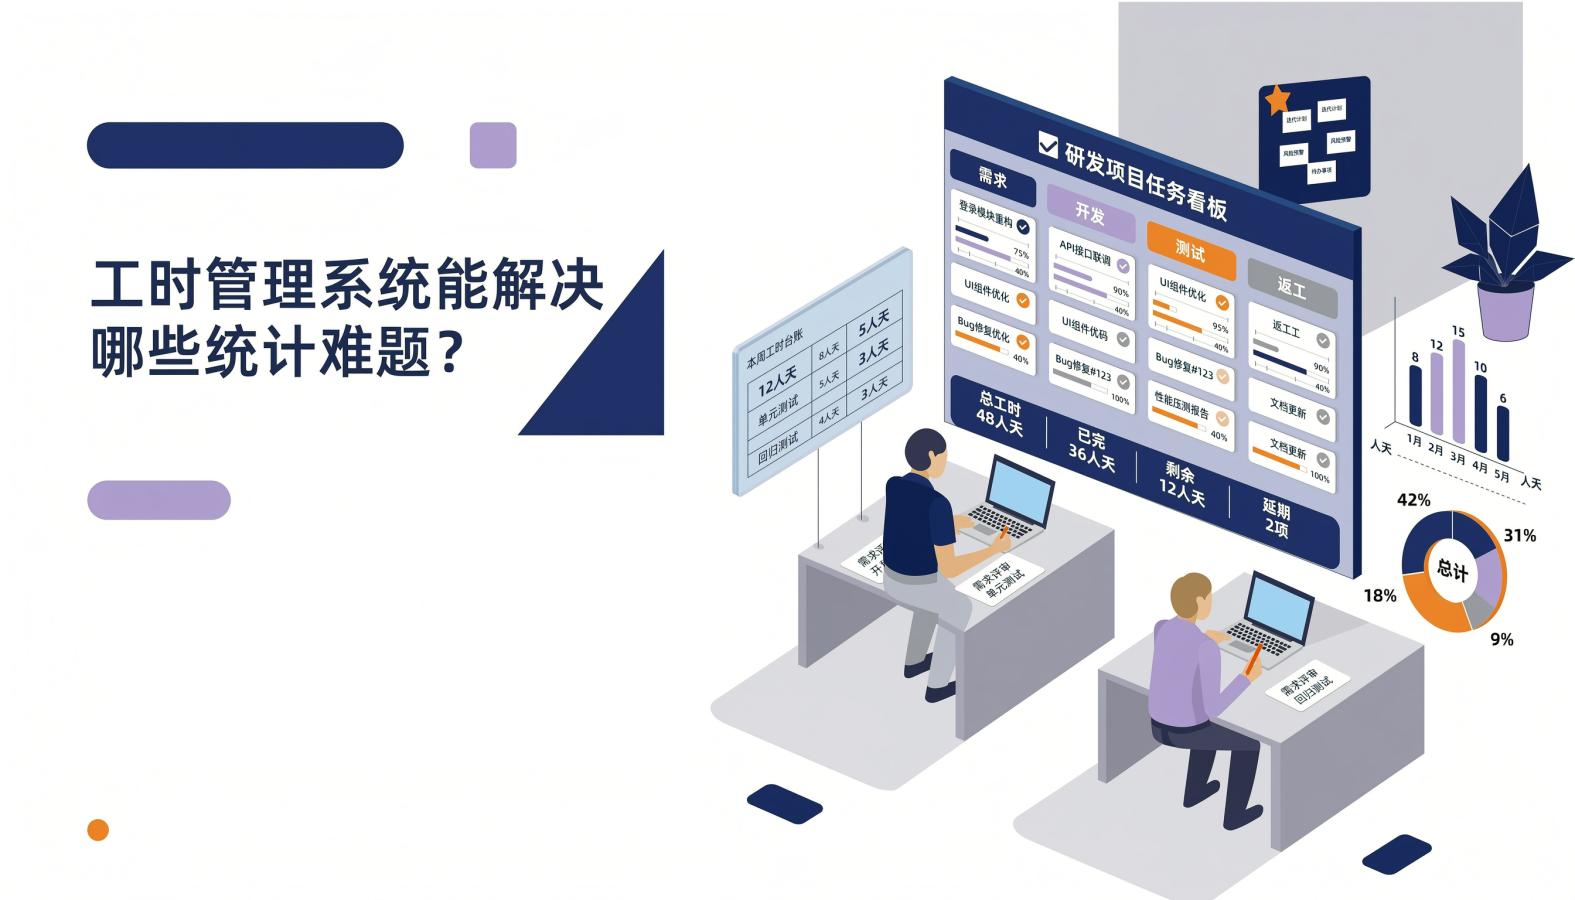
月底关账时,项目工时常常出现几个版本:考勤系统一份,Excel 一份,项目群里还有一份。数字对不上,负责人只能凭经验解释。工时管理系统能解决的,正是这类从记录、归集到解释的统计难题。它不替团队定规则,而是把项目、任务、人员和时间的归属关系固定下来。
不少团队先用通用考勤记录在岗时间,再让成员月底回忆项目投入。考勤只回答人到没到,回答不了时间花在哪个任务上。要把工时用于项目成本、排期和资源判断,记录对象必须从“人到岗”换成“任务投入”。
工时统计为什么总对不上?先看四层断点
统计难题很少是算错,更多是链路断了。
- 记录断点:月底集中补录,短时沟通、等待和返工容易漏掉;同一种工作被记成不同名称。
- 归属断点:只记到项目,没记到任务;一人多项目时靠平均分摊,原始投入被复制。
- 汇总断点:项目编码、人员、统计截止时间和完成定义不一致,几张表无法直接相加。
- 解释断点:只有总工时,没有计划、实际和剩余,无法判断是估算偏低、执行偏差还是范围变了。
系统能补的是链路,不是规则。口径、任务分解和责任分工,仍要团队先定。
工时管理系统能解决哪些统计难题?
| 统计难题 | 系统对应能力 | 判断要点 |
|---|---|---|
| 记录滞后、月底补录 | 工时随任务状态填报 | 开始、暂停、完成时能否直接登记 |
| 多项目分摊说不清 | 工时绑定唯一主任务,跨项目用分摊字段 | 一条记录是否只有一个主归属 |
| 口径不一 | 固定字段、工作类型枚举、单位统一 | 每个字段是否对应一个管理决策 |
| 汇总靠手工 | 按项目、任务、成员、时间交叉统计并导出明细 | 汇总数字能否下钻到原始记录 |
| 进度判断失真 | 预计、消耗、剩余三类工时同时保留 | 剩余工时是否由执行人重新评估 |
| 修改无痕迹 | 审批、补填窗口、修改留痕、权限分级 | 查看、导出、修改能否分开控制 |
六项里最关键的是任务绑定和三类工时。任务绑定决定每条工时有落点,三类工时决定进度能不能判断。缺了这两项,成本报表和效能分析很容易变成对总数的主观解释。项目、任务、工时三层的数据口径也要先统一,具体规则可以参考数据口径。
能力清单:哪些必须有,哪些是加分项
把能力分成“必须有”和“加分项”,比比较功能数量更有用。必须有决定数据能不能用,加分项决定用起来顺不顺、能不能长期维护。
必须有:缺了就很难支撑项目决策
| 能力 | 解决什么问题 | 验收时看什么 |
|---|---|---|
| 工时绑定具体工作对象 | 只挂项目,无法判断投入花在开发、测试还是返工 | 能否从任务、需求或 Bug 页面直接登记 |
| 预计、消耗、剩余三类工时 | 只有实际工时,不知道还要多久 | 任务完成后能否回看三个数 |
| 多维度统计与明细导出 | 汇总能看趋势,明细才能解释数字 | 能否按项目、成员、工作类型、时间交叉筛选 |
| 补填留痕与权限分级 | 工时涉及成本和绩效,修改与查看都要可控 | 补填是否有窗口,修改是否留痕,权限能否分开 |
加分项:决定能不能长期用下去
| 加分项 | 适用情况 | 注意点 |
|---|---|---|
| 与考勤、人力、财务连接 | 需要总量校验或成本归集 | 先确认字段映射和主数据归属 |
| 基线管理与偏差视图 | 需要区分计划变化和执行偏差 | 基线变更要留版本,不能覆盖原基线 |
| 费率配置与自定义字段 | 需要按项目、客户核算,或单独归类返工 | 自定义越深,升级回归和运维成本越高 |
加分项不是越多越好。每增加一个集成、一个自定义字段,都会带来配置、培训和升级成本。先确认必须有,再看加分项能否解决当前最痛的问题。
任务分解与估算口径:工时数据可信的前提
任务分解决定工时有没有地方落。按项目、阶段、任务、子任务逐层拆,至少拆到“有明确完成标准、一个人能负责”的层级。单个任务控制在半天到两天能完成的范围,比较容易估准。任务清单要覆盖需求澄清、方案设计、开发、联调、测试、发布、文档和必要返工,只拆编码会低估基础工时。GB/T 39903-2021《项目工作分解结构》等同采用 ISO 21511:2018,百分百原则要求子单元完整覆盖母单元范围。父级没有拆完,报表里的完成率就只是局部真相。
口径上统一三件事:单位统一为小时或人天;计划工时开始后尽量冻结,调整走变更记录;实际工时当天或次日填写。估算时让执行人参与,先给乐观、常见、悲观三个数,再看同类任务的历史中位数和上四分位。偏差原因分成估算偏低、需求变更、外部依赖、环境等待、质量返工和数据错误几类。
进度基线与偏差:怎么判断项目是不是真的落后
基线不是当前最新的计划,而是经过确认、用来对照的计划快照。项目立项或迭代计划确认后,把范围、关键节点和计划工时固定下来,后续实际数据都和这个版本比较。没有基线,每次调整排期都会把计划改成“看起来合理”的样子,最后永远没有落后。
判断时看两个进度:投入进度是累计实际工时除以计划工时,交付进度是已完成任务的计划工时除以总计划工时。两个数要一起看,只看工时消耗,很容易把估算偏低误判成效率下降。
| 现象 | 可能原因 | 处理动作 |
|---|---|---|
| 消耗高,完成比例也高 | 估算偏低 | 校准同类任务估算,不急着追责 |
| 消耗高,完成比例低 | 返工、阻塞或任务拆分有问题 | 查任务级超估算项和等待原因 |
| 计划没变,节点持续后移 | 执行偏差 | 调整任务安排、补资源或缩小批次 |
| 范围或验收标准变了 | 计划变更 | 走变更流程,建立新基线并保留旧版本 |
基线比较前,先确认统计截止时间、任务完成定义和成员映射一致。日常记录与统计的校验方法,可以参考工时记录与统计。
集成与迁移:选型最容易低估的成本
集成和迁移的成本,往往比功能清单更值得算。
集成先列清单:组织人员来自哪里,考勤数据要不要回写,财务项目编码和费率怎么对应,单点登录用哪套账号体系,任务状态和实际工时以哪个系统为准。每多一个系统,就多一套字段映射、权限边界和故障处理。主数据归属要提前说清楚,否则同一个任务可能在两个系统里出现不同工时。
迁移不只是把数据导进去。历史任务层级、成员账号、工作日志、自定义字段、附件和报表口径,都可能在新系统里变形。验证时抽一个已完成项目和一个进行中项目,检查四件事:任务层级能不能还原、成员投入能不能对上、历史工时能不能查到、报表差异能不能解释。
隐性成本还包括双轨运行期间两边都要填、数据清洗和补录、培训和填报习惯改变、权限矩阵重配、报表重建、升级回归测试。迁移成功的标准不是“数据进去了”,而是团队能按原来的工作逻辑继续做事。
哪些情况系统也解决不了?先做一个小试点
工时管理系统不是所有组织都必须上。主要目的是出勤、请假和薪资结算,项目数量少、人员固定,不需要按项目分摊人力成本,或者管理层不需要任务级投入数据时,通用考勤或表格可能就够用。
系统也解决不了口径没定、任务分解不清、成员不信任数据用途、复盘没有动作这些问题。工具能解决记录在哪里,解决不了按什么规则记录。
如果确实有多项目成本、估算校准和进度偏差判断的需求,可以先用一个完整填报周期试点:选两个项目、20~50 人,观察漏填率、补填率、任务关联率,以及与考勤或工资表的抽样对账差异。再设一个体验标准:新成员 5 分钟内理解字段,3 分钟内完成一条记录。
以禅道为例,任务工时挂在执行模块的任务上,创建、更新、完成任务时填写,任务完成后可以回看最初预计、总计消耗和预计剩余;不同版本对工时、基线和报表的支持范围不同,可以对照版本功能对比确认。先定管理目标和统计口径,再用真实项目跑一个周期,比一次性上全套功能更稳。回到开头的问题,工时管理系统能解决的是统计链路,不是替代管理判断;链路通了,工时数据才有机会从“记过”变成“可用”。
文章标题 :工时管理系统能解决哪些统计难题? ,发布者 :项目管理研究院