三点估算法的核心,是给同一项任务估三个数,再加权算出一个期望工期。它不追求把工期压成一个精确数字,而是把“可能快、可能慢”的范围摆出来,方便团队判断计划该留多少余量。对研发、定制交付这类历史数据少、变数多的项目,这比只报一个“大概 10 天”更有依据。项目管理里常见的返工,往往不是算得不够细,而是只算了一个数,没把不确定性写进计划。
一、三个值分别代表什么
三点估算法也叫 PERT 三点估算,常用三个输入值:乐观时间 O、最可能时间 M、悲观时间 P。三者不是随手取三个数,而是对应三种明确假设。
| 估算值 | 含义 | 取值口径 |
|---|---|---|
| 乐观时间 O | 一切顺利、资源到位、没有返工时可能完成的最短工期 | 不是“压缩后的目标”,而是确实可能发生的最好情况 |
| 最可能时间 M | 正常条件下最常出现的工期 | 基于同类任务的实际经验,不是拍脑袋的愿望值 |
| 悲观时间 P | 关键依赖延迟、出现返工时可能完成的最长工期 | 不是把所有极端风险都叠加,而是合理的最差情况 |
三个值的差距越大,说明不确定性越高。若 O、M、P 几乎一样,三点估算的意义就不大,直接用单点估算更省事。
二、公式怎么算
最常用的是贝塔分布下的加权平均:期望工期 E =(O + 4M + P)÷ 6。最可能时间权重为 4,乐观和悲观各为 1,意思是正常情况最该被重视,极端值只做修正。PMI 的《PMBOK 指南》把三点估算作为估算活动持续时间的工具,并区分三角分布与贝塔分布两种口径。
当历史数据不足、只需要一个大致区间时,也可以用三角分布:E =(O + M + P)÷ 3。它把三个值等权处理,算法更简单,但对最可能时间的经验依赖更弱。
| 分布假设 | 期望工期公式 | 适用判断 |
|---|---|---|
| 贝塔分布 | E =(O + 4M + P)÷ 6 | 有 PERT 口径或团队对最可能时间有把握时优先用 |
| 三角分布 | E =(O + M + P)÷ 3 | 历史数据少、只想快速得到区间时使用 |
两种算法都能用,关键是同一个项目里保持口径一致。不要这个任务用贝塔、那个任务用三角,最后又把结果直接相加。
三、按步骤算一遍
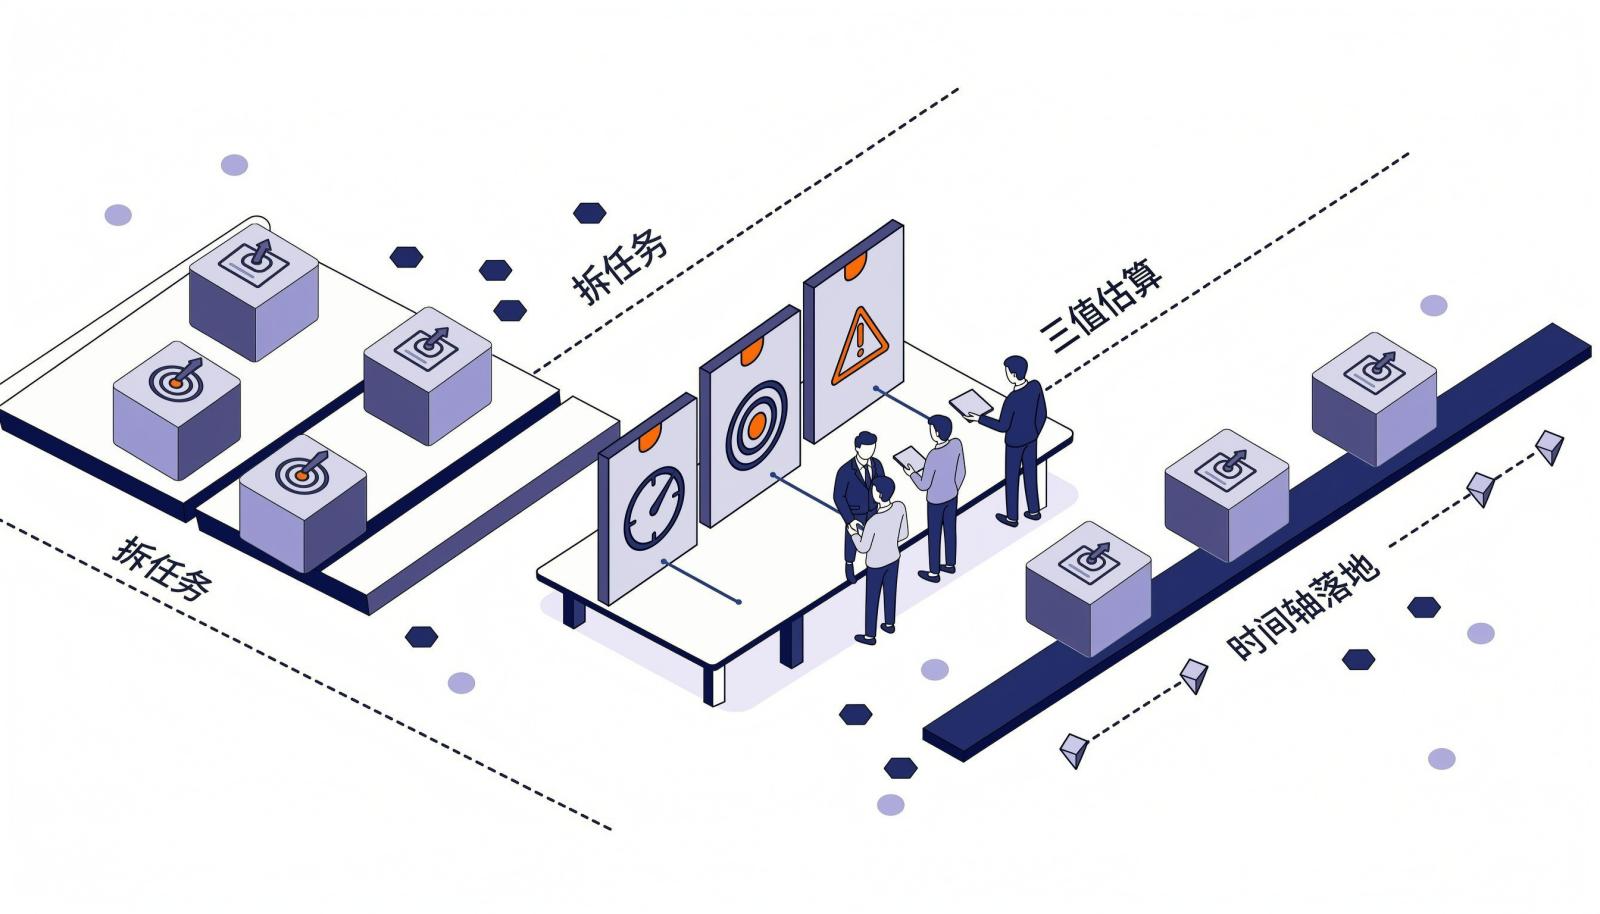
- 拆任务:输入是需求或工作包,动作是按交付物和角色拆到可独立估算的粒度,输出是任务清单。一个任务跨了多个角色、多个交付物,先继续拆。
- 收集三个值:输入是任务说明、资源条件和历史数据,动作是找实际执行的人分别给出 O、M、P 并记录假设,输出是三个有依据的数值。每个值后面写一句假设,比如“O 假设接口文档齐全”。
- 算期望工期:输入是 O、M、P,动作是代入 E=(O+4M+P)÷6,输出是期望工期。以“接口联调”为例,O=2 天、M=3 天、P=7 天,E=(2+12+7)÷6=3.5 天。这个结果表示在给定假设下的平均值,不是承诺值。
- 算离散程度:输入是 O、P,动作是代入 σ=(P-O)÷6,输出是标准差。上例 σ=(7-2)÷6≈0.83 天。σ 越大,工期越不确定;两个任务 E 相同,σ 大的那个更需要留缓冲。
- 换算概率区间:输入是 E 和 σ,动作是按正态近似换算区间,输出是不同把握对应的工期范围。E±1σ 覆盖约 68.3% 的情况,E±2σ 约 95.5%,E±3σ 约 99.7%。上例约 2.7~4.3 天完成的把握约 68%。若只问“不晚于某个时间”,用的是单侧概率,E+1σ 约为 84%。
- 汇总到项目:输入是关键路径上各任务的 E 和 σ,动作是相加期望、把方差求和后开方,输出是项目级进度区间。两个任务 σ 分别为 0.8 天和 1.2 天时,项目 σ=√(0.8²+1.2²)≈1.44 天。标准差不能直接相加。
最容易返工的两个环节,一是三个值的口径不一致:有人把 O 当成领导要求的目标,有人把 P 当成把全部风险都加一遍,算出来的 E 看似精确,实际不可比。二是把 E 直接当承诺:E 只是平均值,按它排期意味着一半左右的把握。规避办法是给每个值附上假设,并在计划里单独标出缓冲,不要把缓冲藏进 P。
四、哪些场景适合,哪些不适合
三点估算法适合不确定性高、历史数据少的任务,尤其是研发、定制交付、系统集成和首次做的新产品。
- 适合:需求边界还在变化、依赖外部接口或供应商、团队没有同类任务的历史数据、需要向管理层说明“有多大把握”的项目。
- 不适合:重复性强、工时稳定、已有可靠历史数据的任务;粒度太细、估算成本高于误差收益的小任务;工期已被合同或硬性节点锁死、估得再细也不能改变交付日的场景。
判断标准不是任务大不大,而是不确定性是否值得被单独量化。一个两周的接口联调,如果依赖三个外部系统,可能比一个两个月的常规开发更需要三点估算。三点估算也能用于成本:把 O、M、P 换成最有利、最可能、最不利成本即可,公式结构不变。
五、怎么和基线、偏差配合
估算只有进入计划、能和实际对照,才会产生管理价值。做法是统一口径、形成基线、跟踪偏差,再用实际数据校准下一轮估算。
- 统一估算口径:任务粒度、工时单位、是否含测试和评审,提前写清楚。跨团队协作时,口径不一致比公式选错更常见。
- 形成进度基线:把批准后的 E、依赖关系和缓冲固化成基线;后续变更走变更记录,不要静默改数。
- 跟踪偏差:用实际消耗与 E 对比,看偏差是偶发还是系统性。连续多个任务都超出 E,说明估算口径偏乐观,下一轮要校准 O、M、P,而不是只催进度。
- 复盘校准:项目结束后把实际工期回收,按任务类型积累数据。下一轮的三点估算就有了自己的历史依据,不再只靠个人经验。
这里可以借助项目管理工具把估算、任务和进度放在同一处。禅道已助力100万+团队构建研发管理平台,覆盖项目管理、任务协作和研发效能管理等环节,适合中大型研发团队把估算结果带进项目计划,再用实际执行数据回看偏差。不同版本的差异可以在版本对比中查看。
文章标题 :三点估算法怎么算?公式和适用场景 ,发布者 :项目管理研究院