需求池管理系统里的需求越积越多,真正难的不是收集,而是决定先做哪一个。排序如果只靠嗓门和职级,团队很快就会陷入反复争论:销售说客户催得急,研发说技术债拖不得,管理者说战略项目不能停。
四种常用方法各有明确边界:价值成本比适合快速粗排,KANO模型适合判断需求属性,RICE评分法适合多需求量化比较,战略对齐适合处理跨目标冲突。先明确要解决的决策问题,再选方法,比套公式更重要。
一、先明确排序要解决的问题
1. 排序是一次资源承诺
需求池管理系统的排序结果,本质上是团队对资源投向的共同承诺。它要回答三个问题:哪些需求必须做,哪些可以等,哪些应该放弃。排序标准不统一,后面的计算越精确,争议反而越大。
2. 四种方法的适用边界
先看一张对照表,判断每种方法解决什么问题、容易在哪里失准。
| 方法 | 核心判断 | 适用场景 | 主要风险 |
|---|---|---|---|
| 价值成本比 | 预期价值与预计投入的比值 | 需求多、信息不全的快速初筛 | 价值口径不一,漏算维护成本 |
| KANO模型 | 需求属于哪类用户属性 | 判断满意度与功能投入的关系 | 把属性分类误当名次 |
| RICE评分法 | 覆盖、影响、信心与投入的综合分值 | 多需求跨团队量化比较 | 数据口径不一致,信心虚高 |
| 战略对齐 | 需求对目标和时间窗口的贡献 | 跨目标冲突与资源取舍 | 标签化,最后仍靠职级拍板 |
这张表说明,四种方法解决不同决策问题。先确认问题属于快速筛选、属性判断、量化比较还是目标取舍,再选方法。
二、方法一:价值成本比
1. 计算口径
价值成本比等于预期价值除以预计投入。价值可以折算为收入增量、成本节约或风险降低,投入通常用人月表示。公式简单,真正的难点是让所有需求使用同一套价值和成本口径。如果A按年度收入估算,B按月活估算,比值就没有可比性。
2. 适用条件与误用场景
适合需求数量多、信息还不完整、需要在一两天内完成初筛的阶段。
常见误用有三种:价值靠提出人主观填写;只计算开发投入,忽略测试、上线和维护成本;把高分直接当成项目排期结论。价值成本比适合做粗排,不适合替代最终决策。它能把明显低价值的需求先放到后面,但不能解释两个高分需求谁先做。
三、方法二:KANO模型
1. 五类需求属性
KANO模型由日本质量管理学者狩野纪昭于1984年提出,论文《魅力质量与必备质量》发表于日本质量管理学会《质量》杂志第14卷第2期第147至156页。它把需求分为五类:必备型、期望型、魅力型、无差异型和反向型。必备型缺失会引发强烈不满,期望型做得越好满意度越高,魅力型超出预期才会带来惊喜,无差异型做与不做差别不大,反向型做了反而招致反感。
2. 如何用于排序
通常用功能型与反功能型两组问题收集用户态度,再按判定表归类。排序时先补齐必备型,再提升期望型,最后根据资源择机做魅力型;无差异型和反向型应降级或放弃。
3. 适用条件与误用场景
适合用户需求分散、功能投入与满意度不成正比的场景。KANO模型判断的是需求属性,不是需求名次。把属性分类直接换算成1到5分排名,会丢掉它最有价值的判断。另一个常见问题是样本偏差:只问重度用户会高估魅力型需求。属性还会随时间迁移,今天的魅力型功能,明年可能变成必备型。
四、方法三:RICE评分法
1. 四个维度与计算
RICE分值等于Reach乘以Impact乘以Confidence再除以Effort。Reach是同一时间窗内受影响的用户数,Impact是固定档位,Confidence是判断把握的百分比,Effort是投入人月。分子衡量价值,分母衡量成本,四项必须在同一口径下填写。
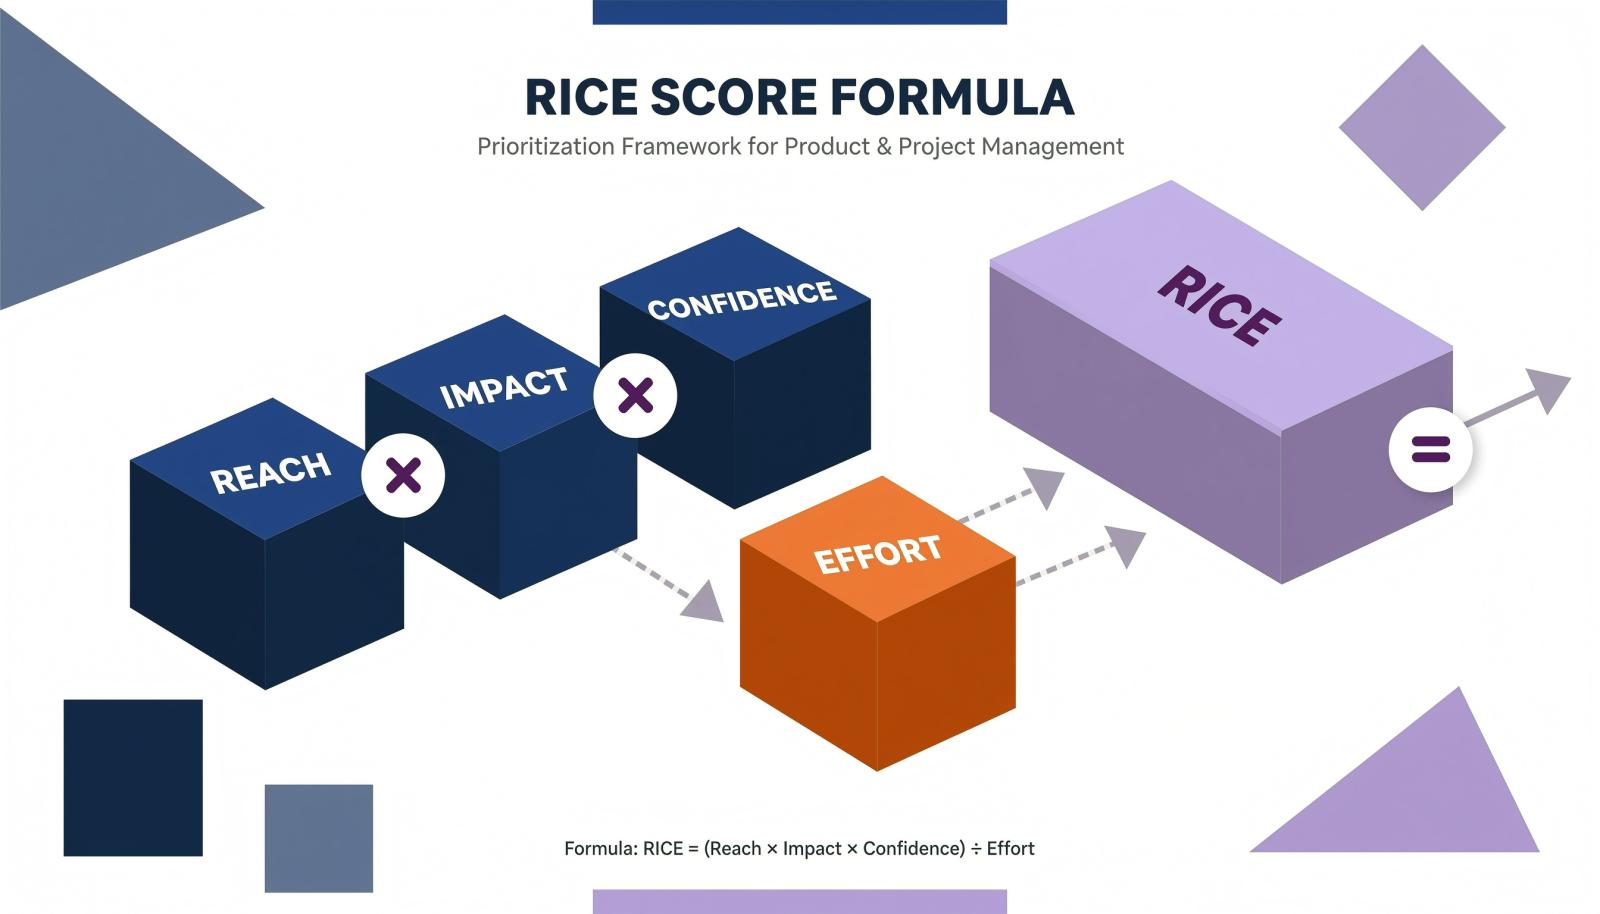
图中分子为Reach、Impact、Confidence,分母为Effort。填写前先统一单位,价值与成本尽量由不同角色评估。
2. 一个评分示例
假设需求A每月影响5000名用户,Impact为3,Confidence为80%,投入2人月,RICE分值为6000。需求B每月影响10000名用户,Impact为2,Confidence为70%,投入5人月,RICE分值为2800。A的分值更高,不是因为覆盖人数更多,而是因为影响强度和投入产出比更合适。
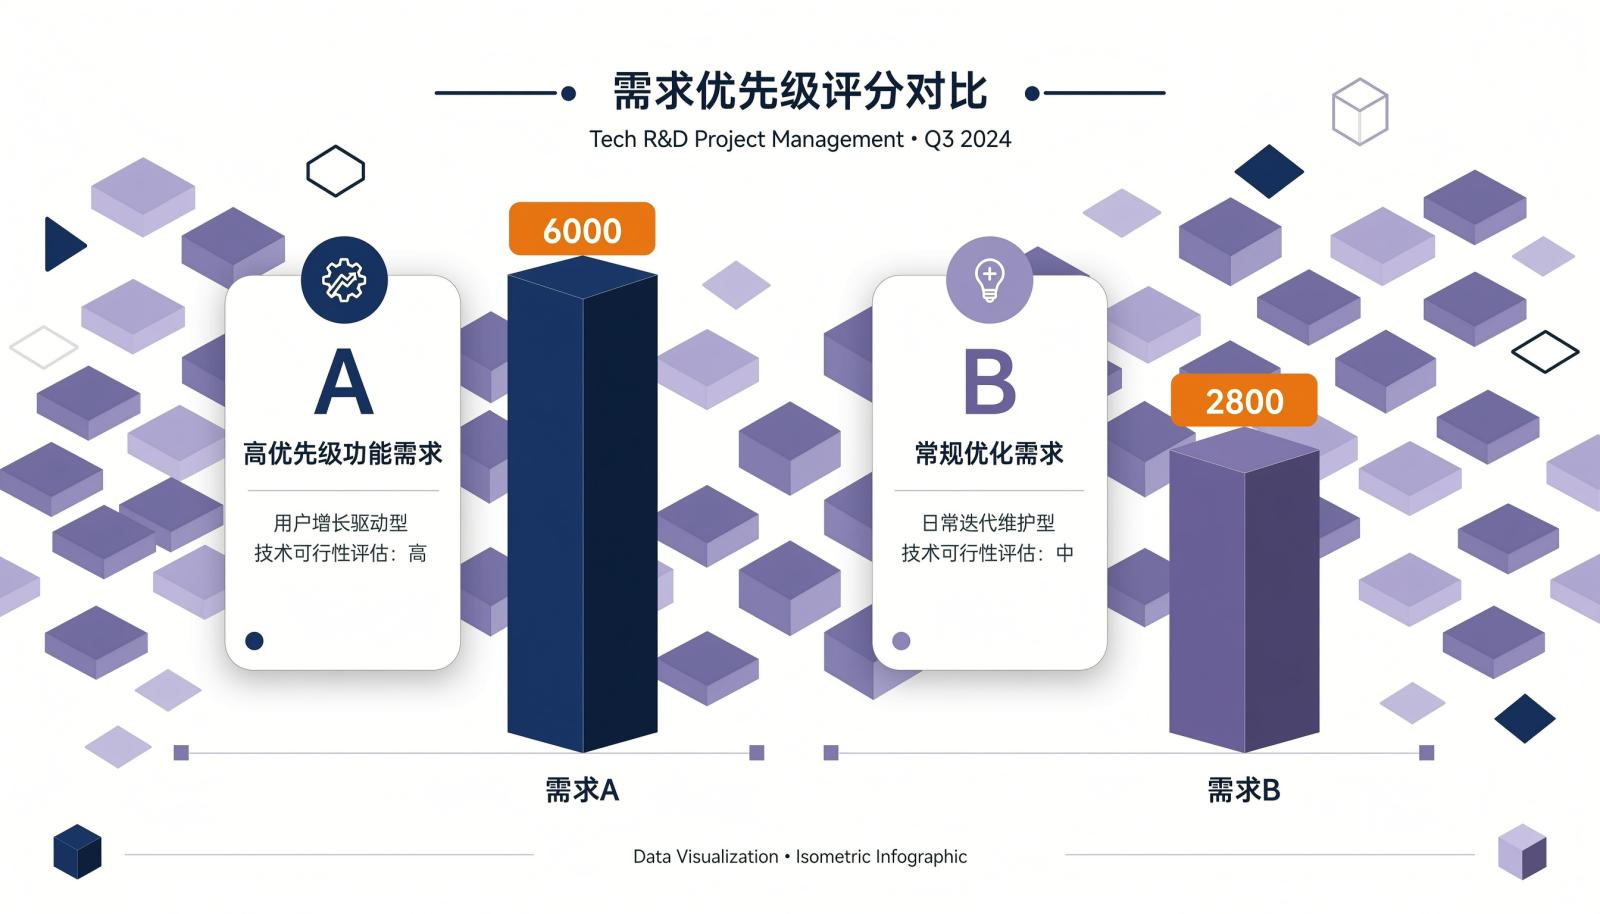
对比图只说明计算关系,不表示A一定优于B。覆盖人数多但把握不足、投入高的需求,排序靠后很正常。
3. 适用条件与误用场景
适合候选需求多、需要跨团队比较、且能拿到基本用户数据的场景。
三类误用最常见:不同团队用不同的Reach统计口径;Confidence凭感觉填成90%;Effort只算开发工时。RICE分值用于辅助比较,不用于宣布绝对答案。建议每次复核都检查口径、数据来源和时间窗。
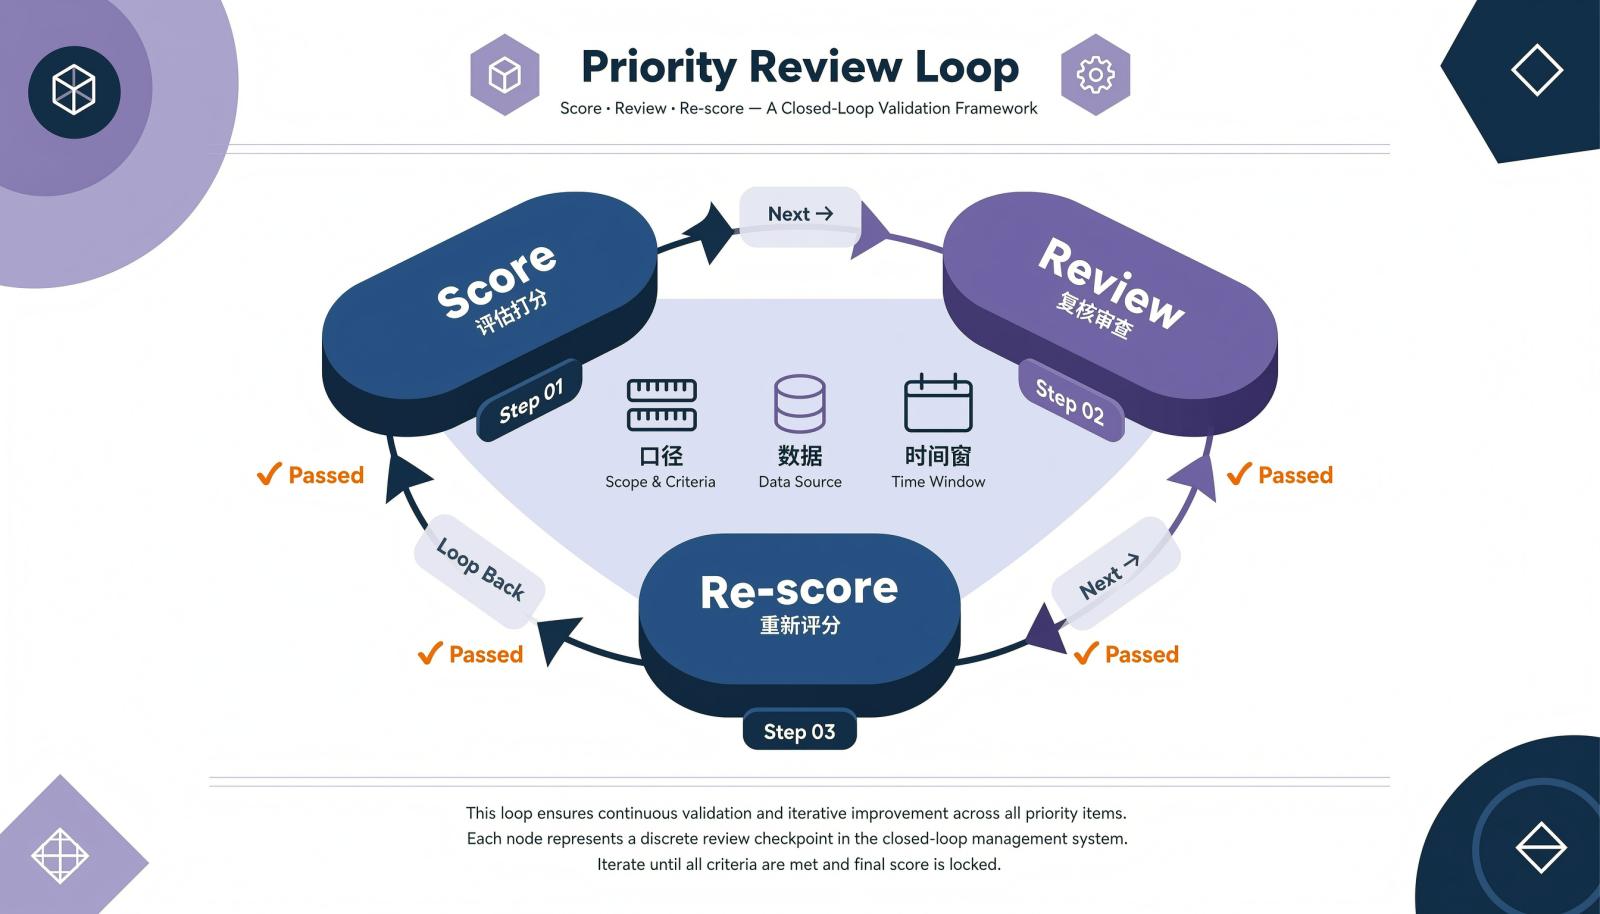
复核闭环可以固定为三步:先核对口径是否一致,再核对数据来源是否可靠,最后确认时间窗是否仍然有效。三项检查通过后,再决定分值是否调整。
五、方法四:战略对齐
1. 判断口径
战略对齐不是给每个需求贴一个战略标签,而是回答三个问题:它支撑哪个目标,影响目标的哪个阶段,错过时间窗口要付出什么代价。可以用目标贡献度、时间窗口、依赖关系三个维度判断。
2. 落地动作
先做产品管理中的目标拆解,把目标拆到季度,再建立需求与目标的对应关系。遇到跨目标冲突,由目标负责人做取舍,并记录取舍理由。战略对齐适合资源有限、目标多元、需要跨部门协同的场景,不适合作为日常排序的唯一依据。否则容易变成所有需求都重要,最后仍由职级决定顺序。
六、组合使用:先分类,再打分,后校准
1. 三步组合路径
三种动作承担不同任务,可以按下面的顺序组合使用。
| 步骤 | 动作 | 产出 |
|---|---|---|
| 分类 | 用KANO剔除无差异和反向需求,识别必备型 | 一份经过筛选的候选清单 |
| 打分 | 用统一口径做价值成本比粗排,再用RICE精排 | 一份可比较的分值顺序 |
| 校准 | 用战略对齐修正顺序,记录例外理由 | 一份可解释的最终优先级 |
先分类能减少无效计算,再打分能拉开差距,后校准能处理目标冲突。三步顺序不宜颠倒,未分类前不要给全部需求打RICE分。
2. 落地时的三个提醒
统一字段:需求池管理系统至少保留价值、成本、信心、战略目标和复核日期,避免重复收集信息。
固定节奏:在敏捷开发节奏中,每两周或每个迭代复核一次,避免分值长期失真。
保留记录:排序理由和变更原因要能追溯,人员变动后仍能解释当初为什么这样排。排序结果不是永久判决,而是一份可复核的当前最优解。
七、FAQ
1. 小团队需要四种方法都用吗?
不需要。先用价值成本比做粗排,再对争议最大的几个需求补一次KANO判断即可。方法数量服从决策需要。
2. KANO问卷需要多少样本?
没有统一门槛。样本应覆盖主要用户类型,数量服从分组分析需要;样本过少时,结论只作参考。
3. RICE分值能跨团队直接比较吗?
不能。Reach口径、Impact档位和Effort单位不一致时,分值不可比。跨团队比较前,先统一统计周期、用户范围和人力单位。
4. 战略对齐会不会变成领导拍板?
会,如果目标没有拆解、取舍没有记录。把目标、影响和代价写清楚,才能把个人判断变成可讨论的依据。回到需求池管理系统里补齐这些字段,排序才有可复核的基础。
文章标题 :需求池管理系统怎么排优先级?四种常用方法 ,发布者 :项目管理研究院