性能测试指标有哪些?常见答案会列出一长串:响应时间、TPS、QPS、并发数、错误率、CPU 使用率。数字本身不难,难的是把不同口径放在一起比较;把指标定义、执行记录和 Bug 闭环放进同一套测试管理流程,历史结果才方便对比。
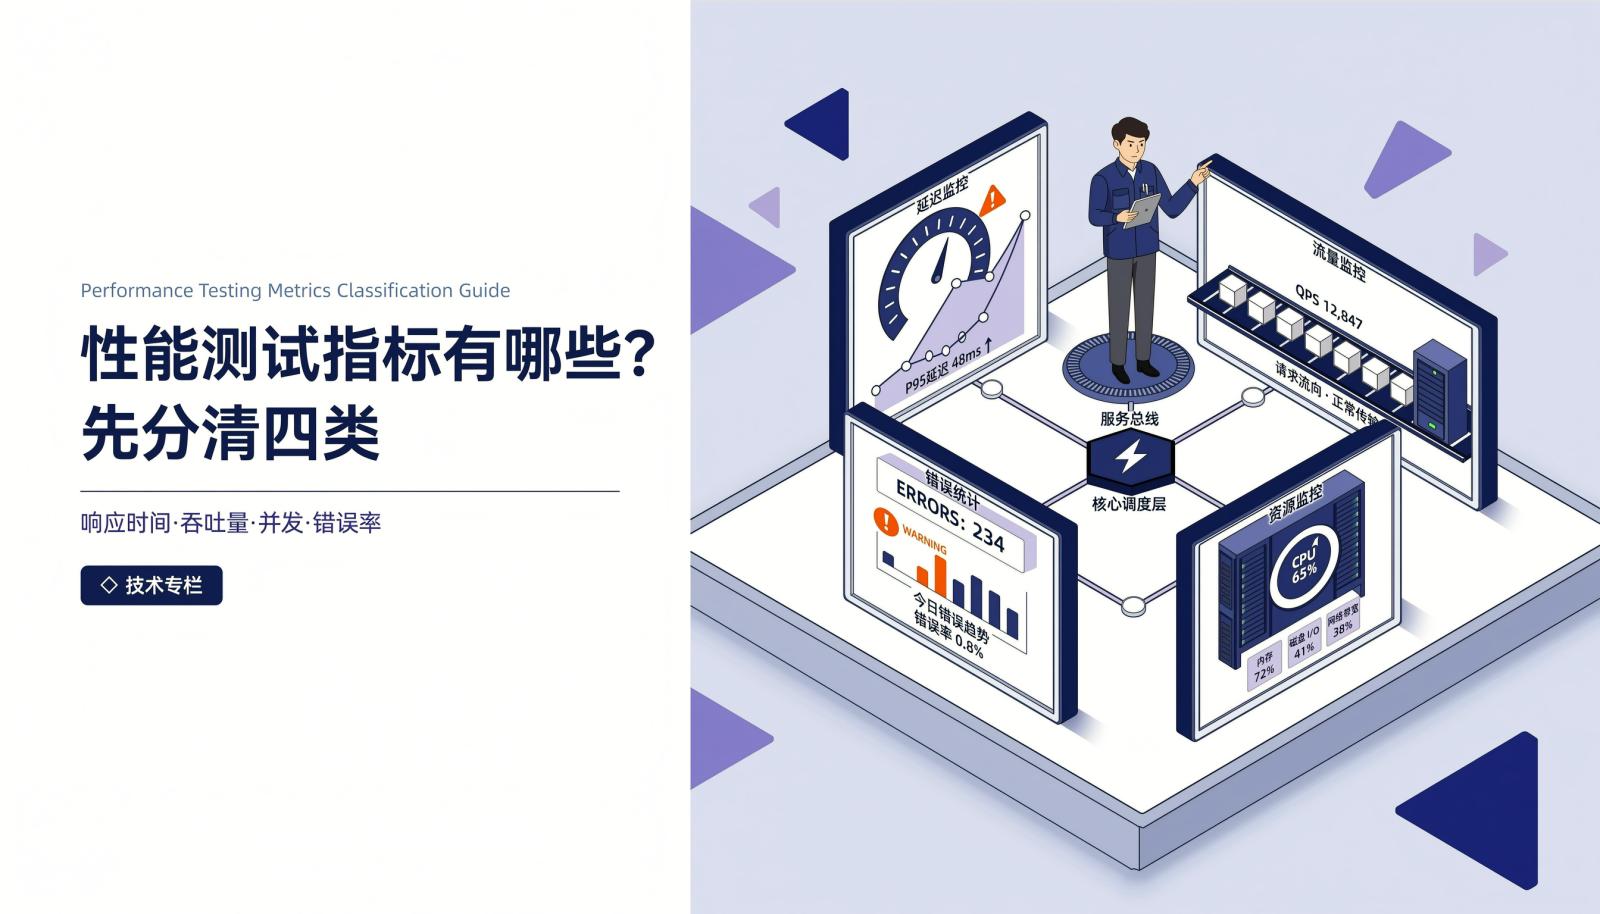
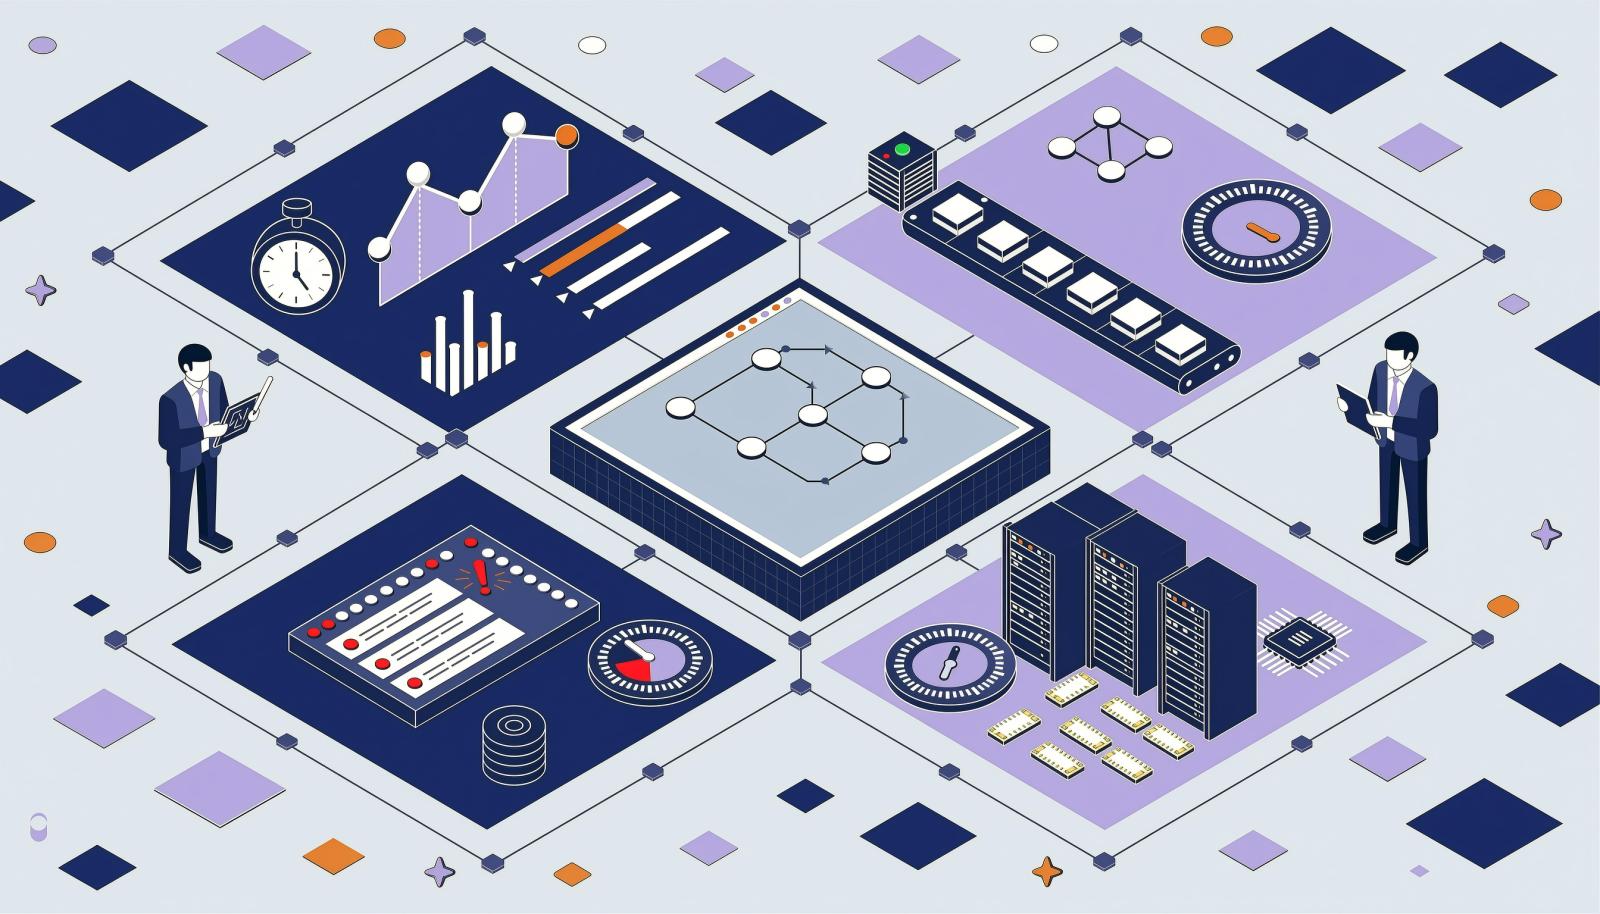
性能测试指标是描述系统在特定负载、场景、环境和数据条件下,响应速度、处理能力、失败情况和资源代价的量化信号。工程团队常把它分成四类:延迟、流量、错误、饱和度。四类分别回答:用户等多久、系统能做多少、失败怎么算、资源离打满还有多远。
下面按四类拆口径、算法和常见争议。阈值不直接给死数,因为业务目标、环境、数据量和版本都会改变结论。
先分清四类性能测试指标
| 类别 | 回答的问题 | 常用指标 | 主要数据源 | 典型误判 |
|---|---|---|---|---|
| 延迟 | 用户等多久 | 平均响应时间、P50/P95/P99、超时率 | 压测工具、APM、网关日志 | 只看平均值 |
| 流量 | 系统能做多少 | QPS、TPS、并发请求数、并发用户数 | 压测工具、网关、业务埋点 | 把并发用户数当吞吐量 |
| 错误 | 失败怎么算 | 系统错误率、业务失败率、成功率、超时率 | 网关、应用日志、业务日志 | 只统计 5xx |
| 饱和度 | 资源离打满多远 | CPU、内存、磁盘 I/O、网络、连接池、队列、GC | 系统监控、容器监控、中间件 | 把利用率当唯一阈值 |
四类不是四个固定数字,而是四种观察角度。Web 接口、批处理、数据库和移动端的重点不同;同一系统在不同测试类型下,也会取不同的观察窗口。
还要把指标和测试类型分开。基准、负载、压力、稳定性是测试类型;四类指标是观察维度。稳定性测试看几个小时内延迟、错误和内存是否漂移,不是看某一瞬间的峰值。
NASA 的软件工程手册把峰值处理能力、持续处理能力、响应时间、CPU 与内存利用率列为典型性能要求。它列的是具体指标,四类给的是观察角度,两者可以对照使用。
延迟:用户等多久,平均值说明不了长尾
延迟通常指请求发出到收到完整响应的时间。先统一终点:是客户端到端,还是服务端处理;是否包含网络、排队和渲染。
平均响应时间 = 成功请求的响应时间总和 ÷ 成功请求数。它能看总体趋势,但会被大量快请求拉低。P95 表示 95% 的成功请求不高于这个值,P99 同理。报告百分位时,要同时给出样本量、统计窗口,并说明是否排除预热阶段。
客户端延迟和服务端延迟不是一回事。用户感知看端到端,定位瓶颈看服务端和依赖调用。
先统一口径,再比较数字。 一个平均 200 ms 的接口,仍可能有 5% 的请求超过 2 秒。样本太少时,P99 只是一个孤立点,不能拿一次结果下结论。挑出尾部 1% 的慢请求,按接口、依赖、SQL、锁等待拆解,再对照同一时间窗的吞吐和错误,才能判断是容量问题还是单点问题。
流量:系统能做多少,并发用户数不是吞吐量
吞吐量是单位时间完成的业务量。TPS 是每秒完成的事务数,QPS 是每秒完成的请求数。一个事务可能包含多个请求,两者不能互换。
TPS = 稳定窗口内成功完成的事务数 ÷ 窗口秒数。窗口要避开加压和减压阶段。报告里要写清事务边界、业务混合比、思考时间和参数化方式,否则结果不可复现。
并发请求数是系统同一时刻正在处理的请求数;并发用户数是同一时刻有操作的用户数。中间还隔着思考时间和请求节奏。可以用利特尔法则做粗略校验:系统内同时处理的请求数 ≈ 吞吐量 × 平均响应时间。这里的并发是请求级,不是登录用户数。
并发用户数高,不代表系统压力大。 用户登录后不操作,实际请求可能很少。做阶梯加压,记录每一级的 TPS、P95、错误率和资源饱和度,找到吞吐不再上升、延迟开始抬头的拐点。短时峰值 TPS 和持续 TPS 也要分开报。
错误:失败率的分母,比分子更容易出错
错误率 = 失败请求数 ÷ 有效请求总数 × 100%。分子好数,分母难定。先定义什么是有效请求,再决定脚本错误、测试数据错误算不算。
系统错误率通常统计 5xx、连接失败、超时、熔断;业务失败率统计 HTTP 200 但业务码失败、库存不足、支付拒绝。两者要分开报。成功率 = 1 - 错误率。
重试会把错误藏起来。 首次成功率和最终成功率不是一回事;重试可能提高最终成功率,却增加延迟和流量。只看 HTTP 5xx 会漏掉业务失败,把业务拒绝都算系统错误又会高估故障。按错误类型、接口、依赖和时间窗分组,抽样核对网关、应用和业务日志,再下结论。
饱和度:资源快满了吗,利用率高不等于性能差
饱和度描述资源接近极限的程度。常见观测项有 CPU 使用率、内存占用、磁盘 I/O 等待、网络带宽、连接池占用、线程池队列和 GC 停顿。
利用率 = 已使用量 ÷ 可用容量。它回答“用了多少”,不直接回答“还能不能扛”。更有效的做法是把利用率和排队信号一起看:CPU run queue、磁盘 await、连接池等待时间、线程池队列长度、GC 暂停时间。利用率不高但排队变长,也可能是锁、连接池或下游依赖的问题。
CPU 70% 或 80% 不是通用红线。 不同业务、CPU 架构和资源超卖比例,安全水位不同。内存占用高不一定是泄漏,要看趋势和回收后的基线。验证时在延迟开始上升的同一时间窗检查各层资源曲线,区分容器限额和宿主机指标,确认是资源、配置还是代码瓶颈。
把指标变成验收:分层责任与质量门禁
测试分层各自负责什么
| 层级 | 主要看什么 | 常见责任方 | 要留下的证据 |
|---|---|---|---|
| 组件/接口 | 单接口延迟、错误、资源占用 | 开发 | 基准结果、版本对比 |
| 服务/集成 | 服务组合、依赖、连接池、错误率 | 测试/性能测试 | 场景脚本、负载模型、瓶颈记录 |
| 端到端业务 | 核心旅程的 P95/P99、成功率、TPS | 测试 + 业务/产品 | 验收口径、业务混合比、结论 |
| 生产运行 | SLO、容量水位、告警、真实流量表现 | 运维/SRE + 业务 | 监控面板、复盘、容量计划 |
这是常见分工,可按组织调整。重点是让每个数字都有负责人和验证动作,而不是把责任推给某一方。
质量门禁怎么设才有约束力
先做一张指标卡,写清六件事:指标名、业务含义、口径与公式、数据源、目标值与统计窗口、责任人。缺一项,后面就容易产生分歧。
门禁分三层:准入看环境、数据和脚本是否可用;准出看核心旅程的 P95/P99、错误率、饱和度和稳定性;发布后看真实流量下同一组指标是否漂移。
必须通过的门槛不要多,控制在 3 到 5 个,每个都对应一个发布风险。例如核心旅程 P95 超标、错误率超标、关键资源持续饱和、长时间稳定性测试期间内存持续上涨,这几类可以阻断发布。能放进 CI/CD 流水线的门禁尽量自动执行;暂时不能自动化的,也要保留记录、责任人和有期限的豁免。
门禁记录最好能按版本、环境和场景回查;只留一张截图,复测时很难解释差异。
例如在禅道这类测试管理工具里,测试单、用例执行、Bug 和测试报告可以关联到同一个项目,门禁证据更容易追溯;门槛值仍要团队按业务目标定义。
不同团队怎么选:最小集、协作集与合规集
| 场景 | 建议指标集 | 节奏 | 门禁重点 |
|---|---|---|---|
| 中大型、多项目 | 核心旅程 P95/P99、TPS、错误率、连接池/队列、资源饱和度 | 每个发布批次 + 月度趋势 | 统一指标卡,跨项目对比 |
| 规模化、强合规 | 增加环境一致性、长时间稳定性、故障恢复、数据完整性 | 阶段评审 + 独立验收 | 证据留存、豁免审批、变更后复测 |
| 单产品起步 | P95、成功率、目标负载 TPS、CPU/内存饱和度 | 每个版本或大改 | 先建基线,3 个必须通过项 |
研发模式也会影响节奏:瀑布模式适合里程碑门禁;敏捷迭代适合每轮基线对比;DevOps 适合把门禁放进流水线,持续看趋势。
合规要求高的行业,重点不是把指标数量翻倍,而是让口径、环境、数据、审批和复测都可追溯。所有阈值都应来自业务 SLO、历史基线和容量规划,不要直接照搬别人的 200 ms 或 70%。
一页行动清单:从下一次压测开始
- 先画一条核心用户旅程,不要从接口清单开始。
- 给旅程定四类指标,每类选 2 到 3 个,写清口径和数据源。
- 用生产峰值和历史基线定目标,不用拍脑袋。
- 先跑基准测试,记录版本、配置、数据和脚本。
- 把必须通过的门槛放进发布流程,其余作为观察项。
- 每次复盘只改一个变量,保留前后对比。
性能测试指标的价值,不在于报表上有多少个数字,而在于团队能不能用同一套口径做判断。先分清四类,再选指标、定门槛、留证据,性能测试才会从一次性的压测,变成可持续的质量管理。
参考资料:NASA Software Engineering Handbook,SWE-199 Performance Measures,https://swehb.nasa.gov/pages/viewpage.action?pageId=82674122
文章标题 :性能测试指标有哪些?先分清四类 ,发布者 :项目管理研究院