自动化测试用例库怎么设计?先给判断:用例库不是脚本仓库,也不是手工用例的电子化备份。它要同时回答三个问题——用例资产放在哪里、每次执行依赖什么数据和环境、哪些脚本能力可以复用。三件事混在一起,用例越多,维护成本越高。
可维护的做法是按顺序推进:先做用例分层,再定测试数据隔离边界,接着把环境配置版本化,最后抽脚本复用层。下面按这条线拆开讲。
用例库先分层,再谈自动化
设计自动化测试用例库,第一层不是目录,而是资产边界。把“验证什么”和“怎么跑”分开,后面换框架、换执行机才不会推倒重来。
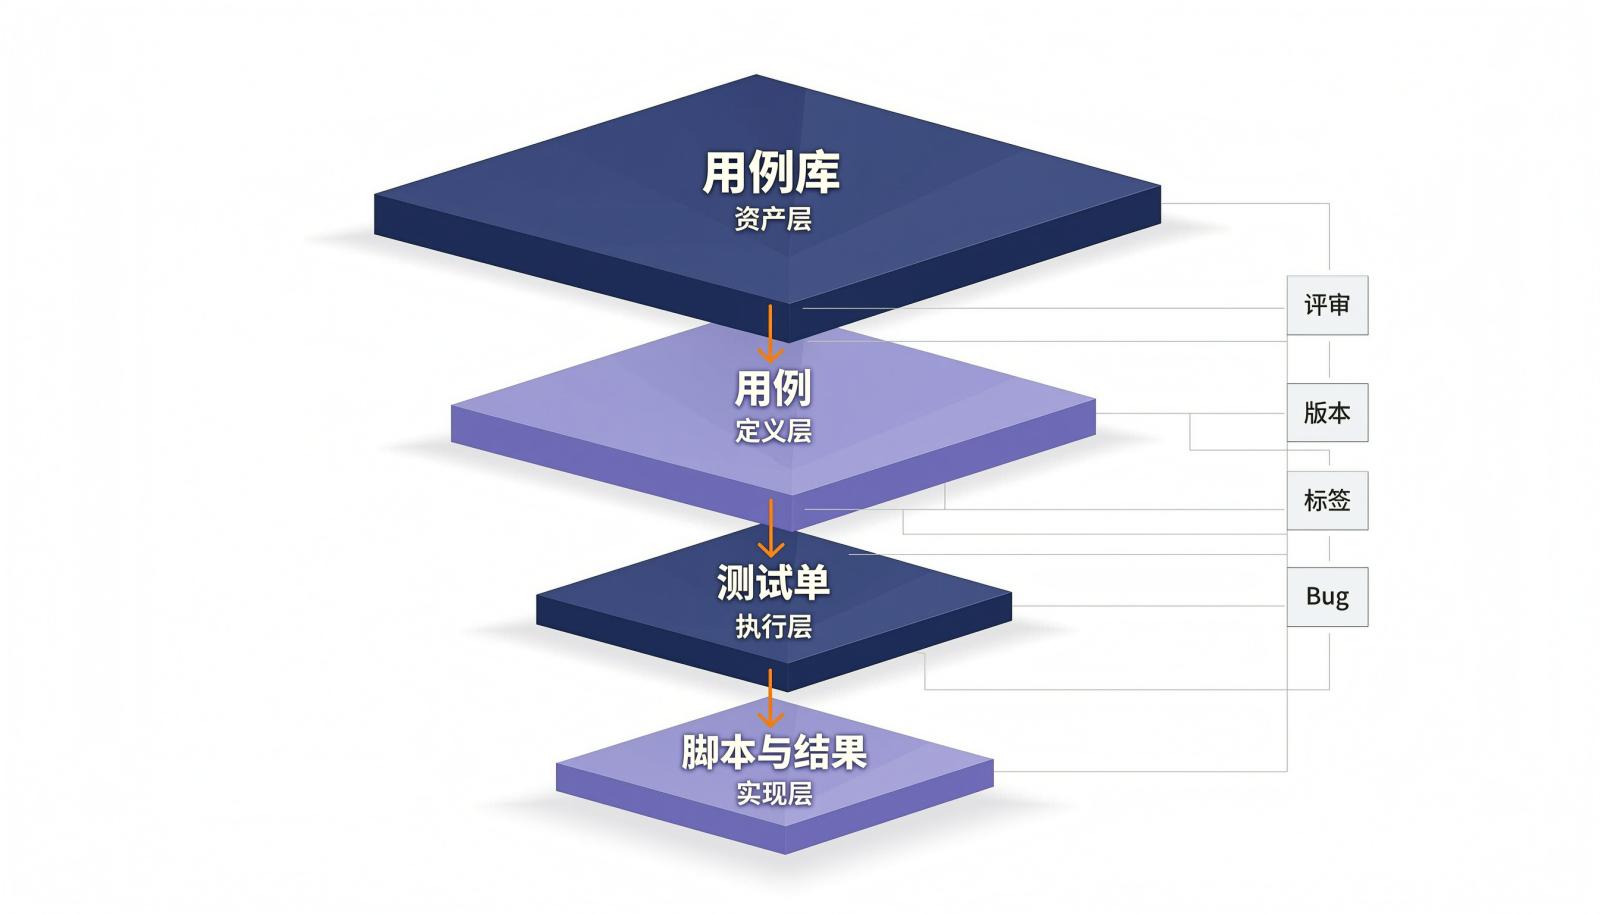
一个可落地的结构通常分四层:
- 用例库:按产品、模块和业务场景组织,保存测试意图、前置条件、步骤和预期结果。它回答“要验证什么”,不绑定某个框架的写法。
- 用例:一条用例只表达一个意图,步骤和预期结果可分开维护,能评审、能打标签、能关联需求和版本。
- 测试单:一轮执行对应一张测试单,关联本轮要跑的用例,记录执行人、执行结果和备注。测试单是执行记录,不是用例本身。
- 脚本与结果:自动化脚本通过用例 ID 或标签与用例关联,执行结果回传后仍能落回原用例。脚本可以替换,用例资产不跟着消失。
在禅道里,这条链路是现成的:用例库维护资产,用例承载步骤和预期,测试单关联本轮用例并记录执行结果,失败的用例可以直接转 Bug。用例步骤还能逐条设置预期值,撰写用例步骤时最多支持三层,执行和统计不会混在一起。创建测试用例
判断分层是否成立,有个简单检验:换一个自动化框架后,用例还能被找到、被执行、被追溯,说明资产层是独立的;如果脚本一改,用例就找不到,说明脚本成了用例库的唯一入口。
测试数据隔离:先定边界,再选方案
测试数据隔离的目标不是把所有数据都保留,而是每个用例都从可预期的状态开始,执行完不留影响下一次的残留。
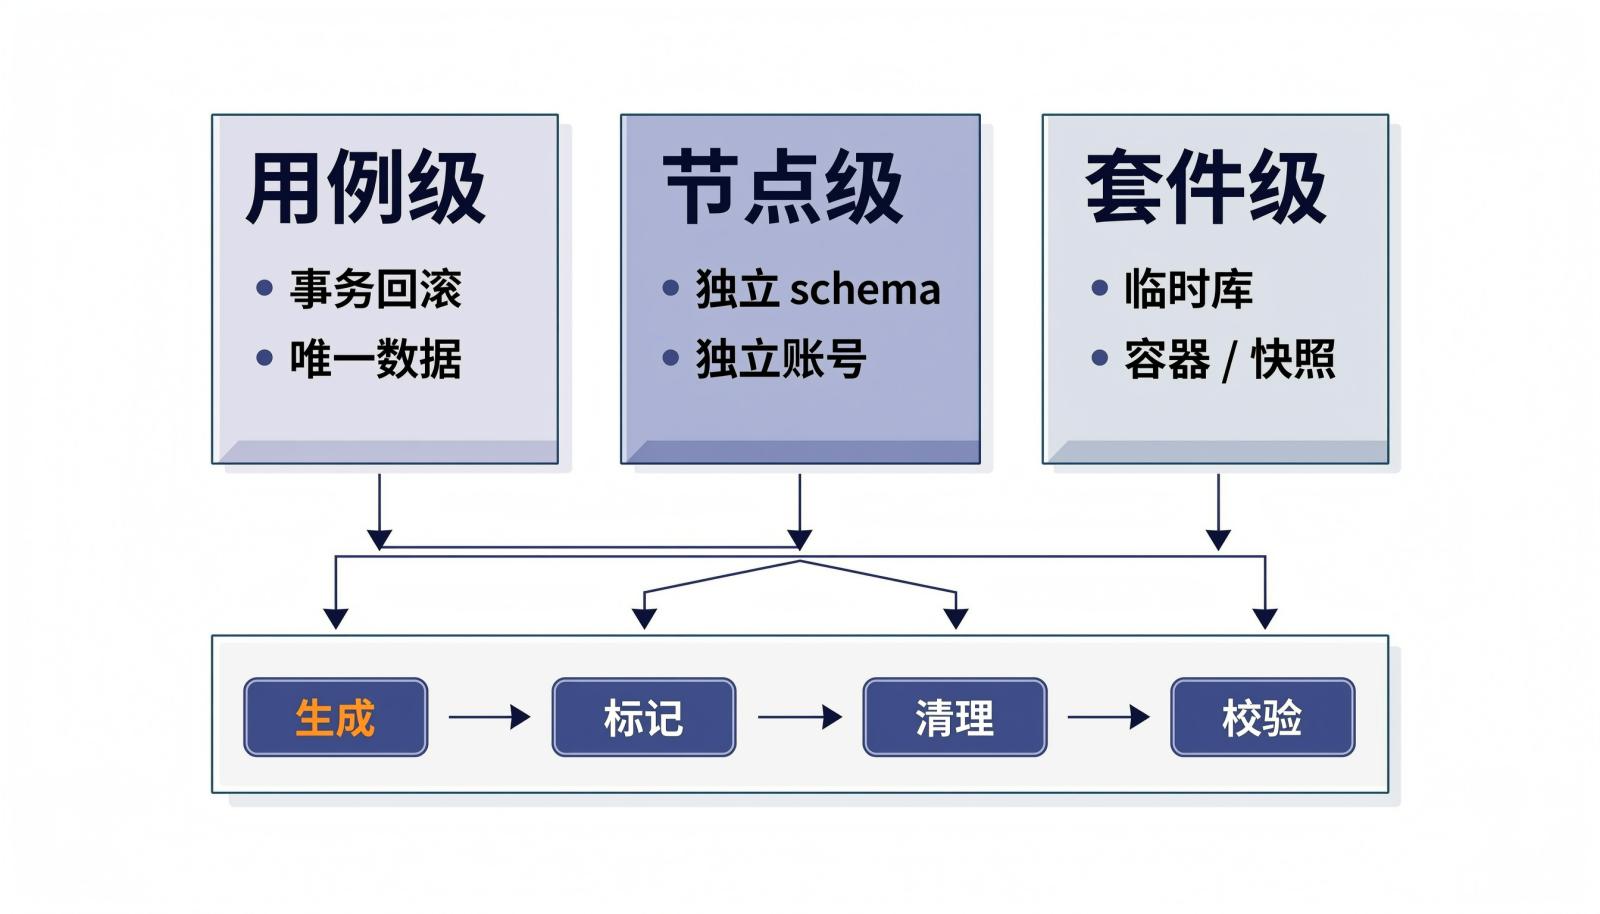
先选隔离边界,再选工具。常见有三种:
- 用例级:每个用例创建自己的唯一数据,结束后删除;数据库测试可用事务回滚。成本低,适合大多数接口和单元测试。
- 节点级:每个并行 worker 使用独立 schema、命名空间或测试账号,避免并发写同一张表。适合并行执行。
- 套件级:为一批集成测试拉起临时数据库或容器,跑完销毁;也可以用基线快照恢复。隔离更彻底,成本更高。
三种边界的对比如下:
| 隔离边界 | 隔离强度 | 并行友好 | 主要成本 | 适用场景 |
|---|---|---|---|---|
| 用例级 | 中 | 中 | 低 | 接口、单元、多数业务用例 |
| 节点级 | 较高 | 高 | 中 | 多 worker 并行回归 |
| 套件级 | 高 | 高 | 高 | 集成测试、跨服务链路 |
并行越多、依赖越复杂,隔离边界越应该上移;不要用共享账号和共享数据去换一点准备时间。
无论选哪种,都建议给测试数据打上本轮执行的唯一标记,例如 test_run_id,清理时按标记删除,最后再做一次残留校验。共享 test_user_123、依赖上一个用例创建的数据,是后面连锁失败和偶发失败的常见来源。
数据生命周期可以固定为:生成→标记→使用→清理→校验。标记和校验两步不能省,否则“看起来清理了”会在下一轮变成新的脏数据。禅道测试管理中的自动化测试框架 ZTF 与数据生成器 ZenData 也按这个思路衔接:ZTF 执行自动化测试,脚本读取 ZenData 生成的数据文件,让数据和脚本分开。禅道测试管理
环境配置要可重复,不能靠手工记忆
测试环境配置的核心不是把参数填对,而是让同一份构建产物在本地、CI 和测试环境里按同一套规则启动。依赖版本、数据库迁移、测试账号和外部服务,只要有一项靠手工记忆,结果就不可重复。
配置可以分三层管理:
- 公共默认值:框架版本、超时、日志级别等大多数环境一致的配置,放进代码库。
- 环境差异:地址、端口、数据库连接等按环境注入,优先使用环境变量或配置中心,不写死在脚本里。
- 敏感凭据:账号、密钥、令牌交给密钥管理,不入代码库,也不打进镜像。
十二要素应用把配置放在环境变量里,就是为了让同一份代码在不同部署间只换配置、不换代码。测试环境同样适用。
启动测试前加一道健康检查:依赖服务是否可达、数据库版本和迁移是否就绪、测试账号是否可用。检查不通过就直接失败,不要等用例跑到一半才报连接错误。
容器化和 Testcontainers 适合需要真实依赖的集成测试:按需拉起数据库、消息队列等容器,测试结束自动清理,避免多人共用一套环境造成配置漂移。Testcontainers
环境晋升也按同一思路:本地→CI→测试→预发,每层使用同一镜像或构建产物,只替换配置;每次晋升先跑冒烟用例。这样环境问题会早暴露,而不是在回归最后一天集中爆发。
脚本复用复用的是能力,不是流程
自动化测试脚本复用做得好,减少的是重复代码;做得过头,减少的是可读性和定位能力。复用的边界应该停在稳定能力上,不要把所有业务步骤包成一个“万能脚本”。
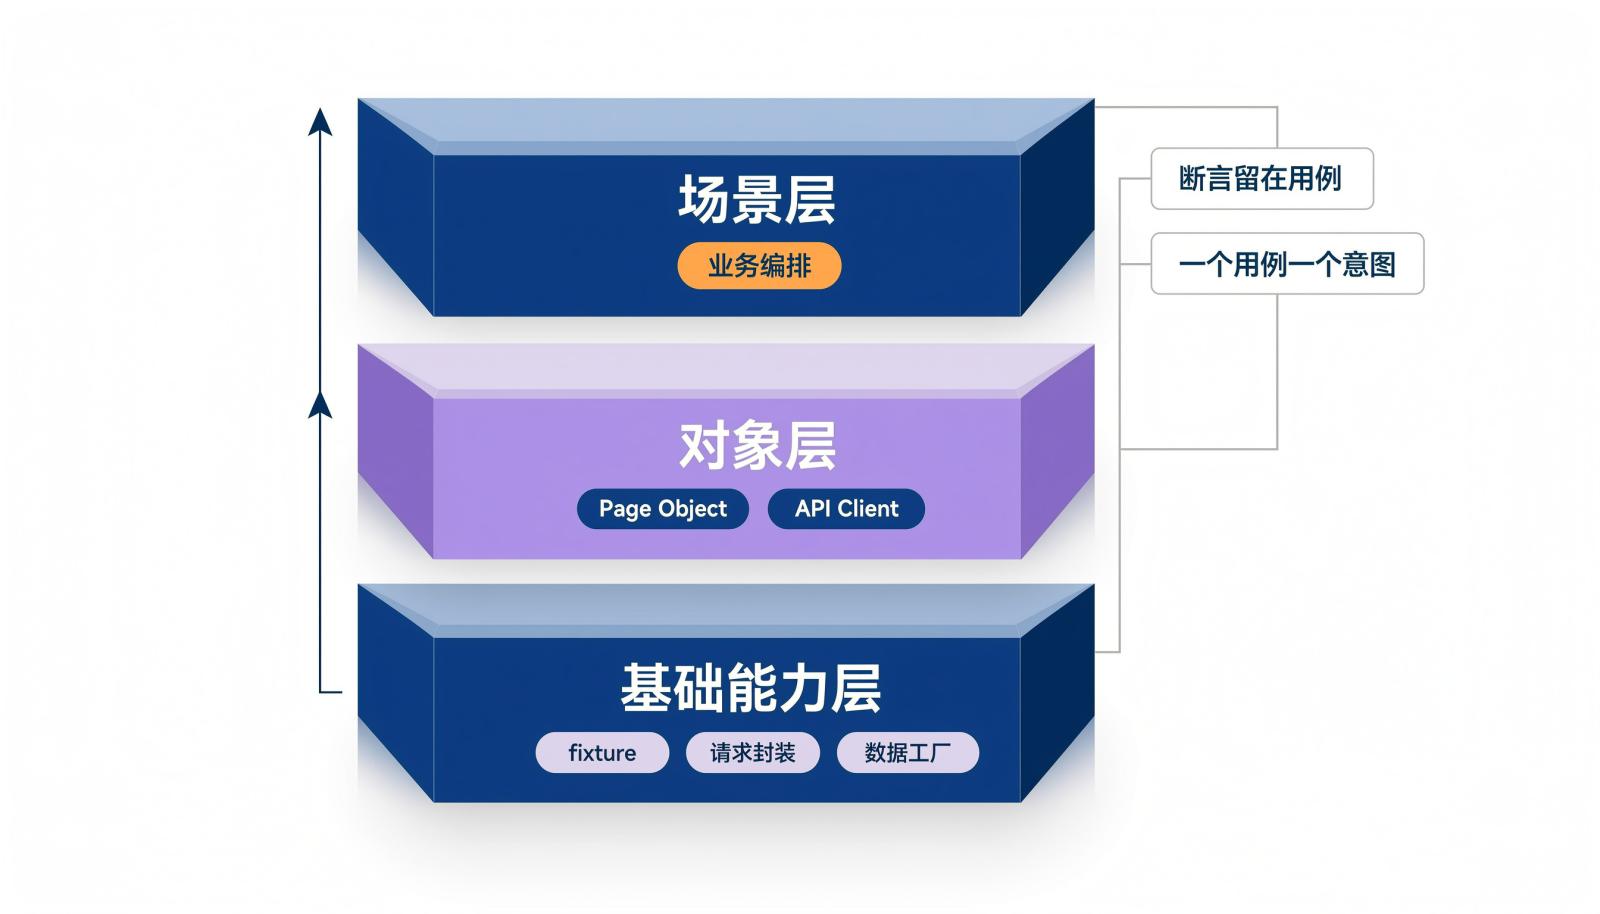
可以分三层:
- 基础能力层:登录、请求封装、断言工具、数据工厂、清理逻辑,放进 fixture 或公共库,供所有用例调用。
- 对象层:Page Object 封装页面元素和操作,API Client 封装接口契约;界面或接口变了,只改这一层。
- 场景层:编排“下单→支付→退款”这类业务流程,只负责步骤组合,不隐藏关键断言。
不该复用的是具体断言、测试意图和一次性的数据准备。把它们塞进公共脚本,失败时很难判断是业务坏了,还是封装层把错误掩盖了。
几条约束比“多抽象”更重要:一条用例只保留一个主要意图;公共步骤下沉,但断言留在用例里;用例之间不依赖执行顺序;复用层要有负责人和变更记录。Playwright 官方最佳实践也强调每个测试使用独立上下文、不依赖其他测试;pytest 的 fixture 则通过作用域控制共享范围,默认让每个测试拿到独立数据。Playwright 最佳实践|pytest fixtures
以禅道为例,用例、测试单、执行结果和 Bug 在同一条链路里,自动化脚本回传结果后,团队仍然回到用例维度看覆盖和失败原因,而不是在脚本日志和用例表之间来回对。
落地顺序与检查清单
如果从零开始,建议按四步走:盘点现有用例并按产品、模块归档;确定用例、测试单、脚本的命名和关联规则;选一个隔离边界,先在一条回归链路上跑通;接入 CI,补上结果回传和失败归因。
上线前可以用这张清单自查:
- 每条用例能独立执行,不依赖前一条的数据或顺序。
- 测试数据有唯一标记,执行后能按标记清理并校验。
- 环境配置与代码分离,敏感信息不入库。
- 测试单能追溯到用例、版本和执行结果。
- 脚本复用层有边界,断言没有被公共封装吞掉。
- 失败结果能回到用例和 Bug,而不是只留在流水线日志里。
据《2025年软件测试行业现状调查报告》,禅道连续 11 年获评常用测试管理工具第一名。对已经在用禅道的团队,用例库、测试单、测试执行和 Bug 管理在同一套系统里,自动化结果回传后更容易形成闭环。一套可维护的自动化测试用例库,最终要让人能追到用例、数据和环境,而不是只看到一堆脚本。
常见问题
用例库需要和自动化脚本一一对应吗?
不需要。一条用例可以有手工和自动化两种实现,脚本通过用例 ID 或标签关联即可。用例库保存验证意图,脚本负责执行,两者不是一对一关系。
并行执行不多,还要做测试数据隔离吗?
至少要保证每条用例使用自己的唯一数据,并在结束后清理。隔离边界可以先用用例级,等并行度上来再切到节点级或套件级。
测试环境能直接使用生产数据吗?
不建议。生产数据应脱敏或替换为合成数据,测试环境使用独立凭据和独立账号,并禁止向生产写入。需要真实数据分布时,也应先做脱敏和访问控制。
文章标题 :自动化测试用例库怎么设计?测试数据隔离、环境配置与脚本复用 ,发布者 :项目管理研究院