研发项目管理工具真正的价值,不是把表格搬到线上,而是把需求、任务、代码、测试和发布串成一条可追溯的交付链。只拿它记进度,团队依旧会在群聊里追问;把每个阶段的输入、输出和通过标准定清楚,工具才会成为协作的基础设施。
一、先把全流程看明白
1. 五个阶段各自交付什么
研发从需求到发布,不是五个部门各管一段,而是五次交接;每次交接都要有明确产物,下一段才能顺利开始。
| 阶段 | 关键输入 | 核心动作 | 主要输出 | 通过标准 |
|---|---|---|---|---|
| 需求 | 用户反馈、业务目标 | 收集、评审、定优先级 | 可验收的需求条目 | 有负责人、有验收标准 |
| 计划 | 已确认需求、团队容量 | 拆任务、排依赖、定节奏 | 可执行的任务计划 | 每项任务有估算和截止时间 |
| 开发 | 任务、设计说明 | 开发、评审、持续集成 | 可测试的构建 | 代码通过评审并可部署 |
| 测试 | 构建、需求、用例 | 执行用例、记录Bug、回归 | 测试报告与Bug清单 | 阻断Bug清零或有明确处置 |
| 发布 | 发布清单、回滚方案 | 灰度、监控、验证 | 发布记录 | 指标正常且可回滚 |
五行的共同点是每段都有可验证的输出。缺一项,后面的计划、测试或发布就会靠猜。
2. 工具负责连接,判断仍由人做
研发项目管理工具的价值,在于让流程有记录、可追溯。它擅长三件事:同一份数据只录一次,状态变化留下时间和责任人,上下游对象可以互相跳转。流程怎么定、谁拍板、什么算完成,仍要由团队决定。把判断权交给字段,只会制造更多无效审批。
3. 起步只统一三件事
基础字段不统一,后面就会不断用补丁补流程。先统一三类对象:需求、任务、Bug。每条记录至少写清负责人、优先级、截止时间、验收标准和当前状态。状态名不求多,但每个状态都要对应一个明确动作,否则看板只会显示颜色,不能说明工作如何流动。
二、需求阶段:把想法变成可验收的条目
1. 统一入口,先分清层次
需求阶段最大的浪费,是同一件事在聊天里被反复解释,却没人写清什么叫完成。做法是统一入口,所有想法先进入需求池,再区分产品需求、研发需求和改进项。一句话可以直接记录,但不能直接变成开发任务。
2. 评审只盯四个要素
评审不必面面俱到,只看四件事:解决谁的问题、边界在哪里、怎样验收、何时需要。写不出可观察结果的条目,先退回澄清;写得清但价值不高的,进入待排期,不占用当前迭代容量。
3. 变更要留痕,并同步下游
需求通过后形成基线。后续可以变更,但要记录原因、影响范围和审批人,并同步关联的任务、用例与发布计划。没有留痕的口头变更,最后往往变成延期和互相扯皮的起点。
三、计划阶段:从需求拆到可执行任务
1. 按交付物拆任务
拆任务按可交付物拆,不按工种拆。一个任务应能独立完成、独立验证,通常控制在一个迭代内;跨角色协作写进任务说明,不要把同一件事拆成设计、开发、测试三条互不相干的记录。
2. 排期先算容量,再排依赖
先把成员可用工时、会议和休假扣掉,得到真实容量;再标出前后置关系,识别关键路径。排不进去的需求回到需求池,而不是靠加班硬塞。计划一旦超出容量,执行阶段就只能靠延期来纠偏。
3. 跟踪看流动,不只看完成率
用看板跟踪时,每周看三件事:在制品是否过多、任务等待时间是否变长、阻塞项是否有人处理。完成率高但大量任务卡在评审或测试,说明瓶颈不在开发端。此时继续催开发,只会让堆积更严重。
四、开发与测试:让状态自己说话
1. 任务要能追到代码和构建
开发阶段的关键不是每天更新状态,而是让任务能追到代码、构建和测试结果。提交代码时关联任务编号,构建失败自动回到责任人,测试环境部署后通知测试人员。出现问题时沿着同一条链定位,比翻聊天记录可靠。
2. Bug要按状态机流转
Bug按新建、确认、修复、验证、关闭五个状态流转。确认阶段判断是否为Bug、影响哪些版本;修复时填写原因和影响范围;验证不通过就回到修复,不直接关闭。延期和拒绝也要写原因,否则Bug列表会失去可信度。
一份公开的软件开发生命周期指南援引2024年研究指出,软件测试成本约占系统开发成本的三分之一。这不意味着测试越多越好,而是说明测试策略值得被当作发布前的核心设计。
3. 变更前先做影响分析
需求、设计、代码、用例和发布计划之间存在关联,改动一处要看到受影响的下游对象。影响范围不清时,先缩小变更批次,再安排回归测试。一次大改把风险带到发布当天,通常不是测试不努力,而是变更没有提前拆小。
五、发布阶段:用三道防线控制风险
1. 发布前:五道门禁全部有责任人
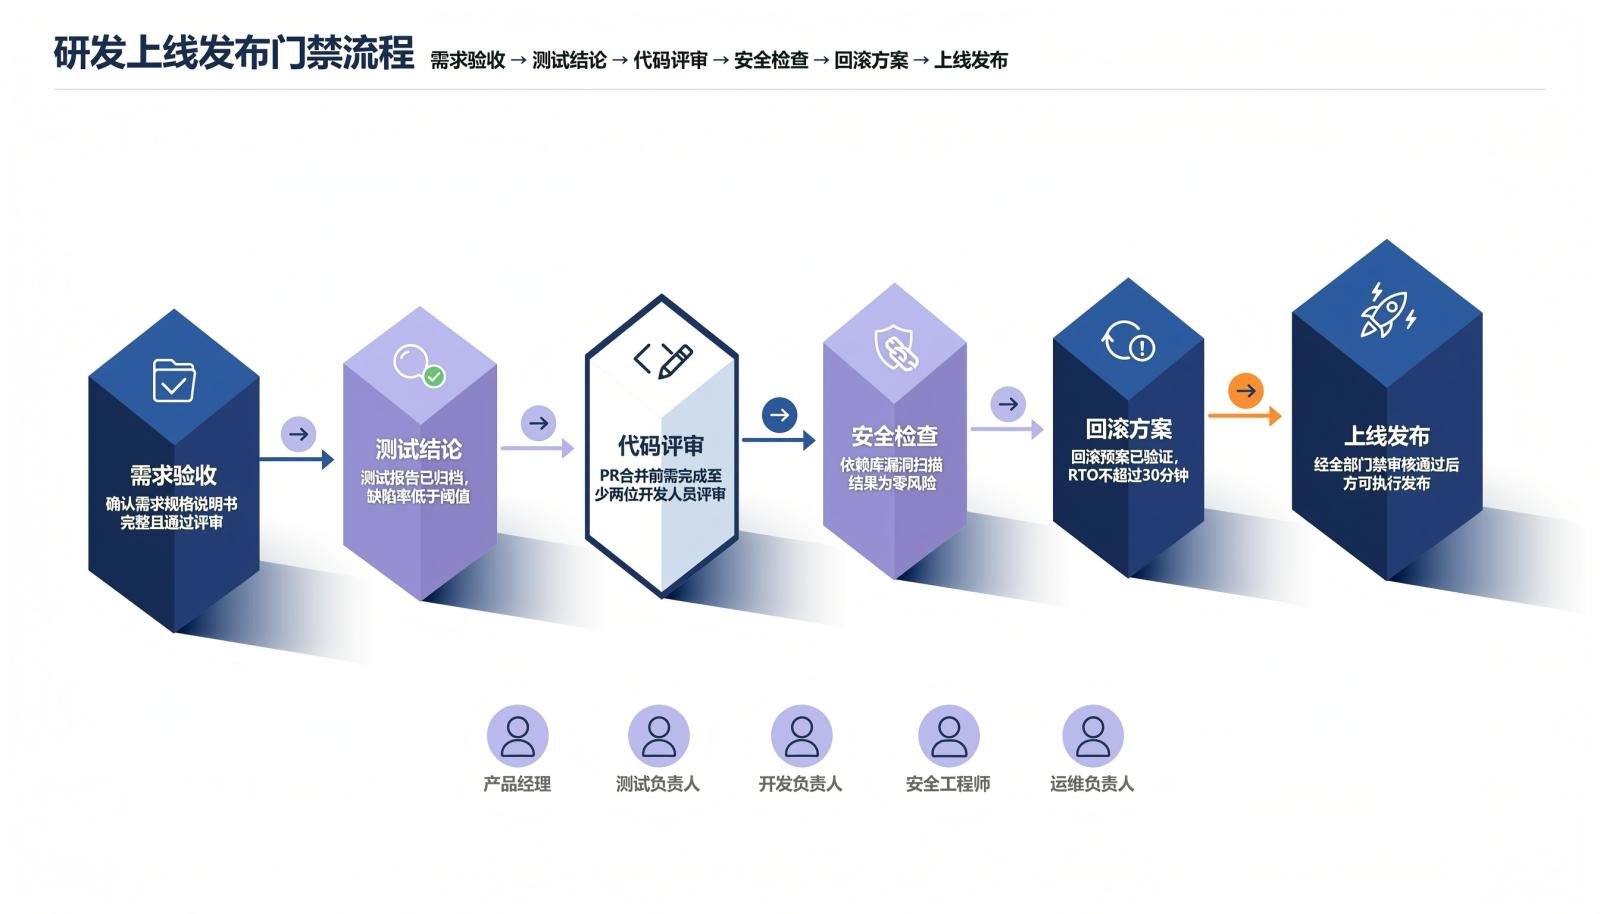
发布前设五道门禁:需求验收完成、测试结论明确、代码评审通过、配置与安全检查完成、回滚方案可执行。每道门禁都要有责任人,口头确认不算通过。任一门禁缺失,发布就应暂停,而不是带着已知风险上线。
2. 发布中:灰度节奏与观察指标
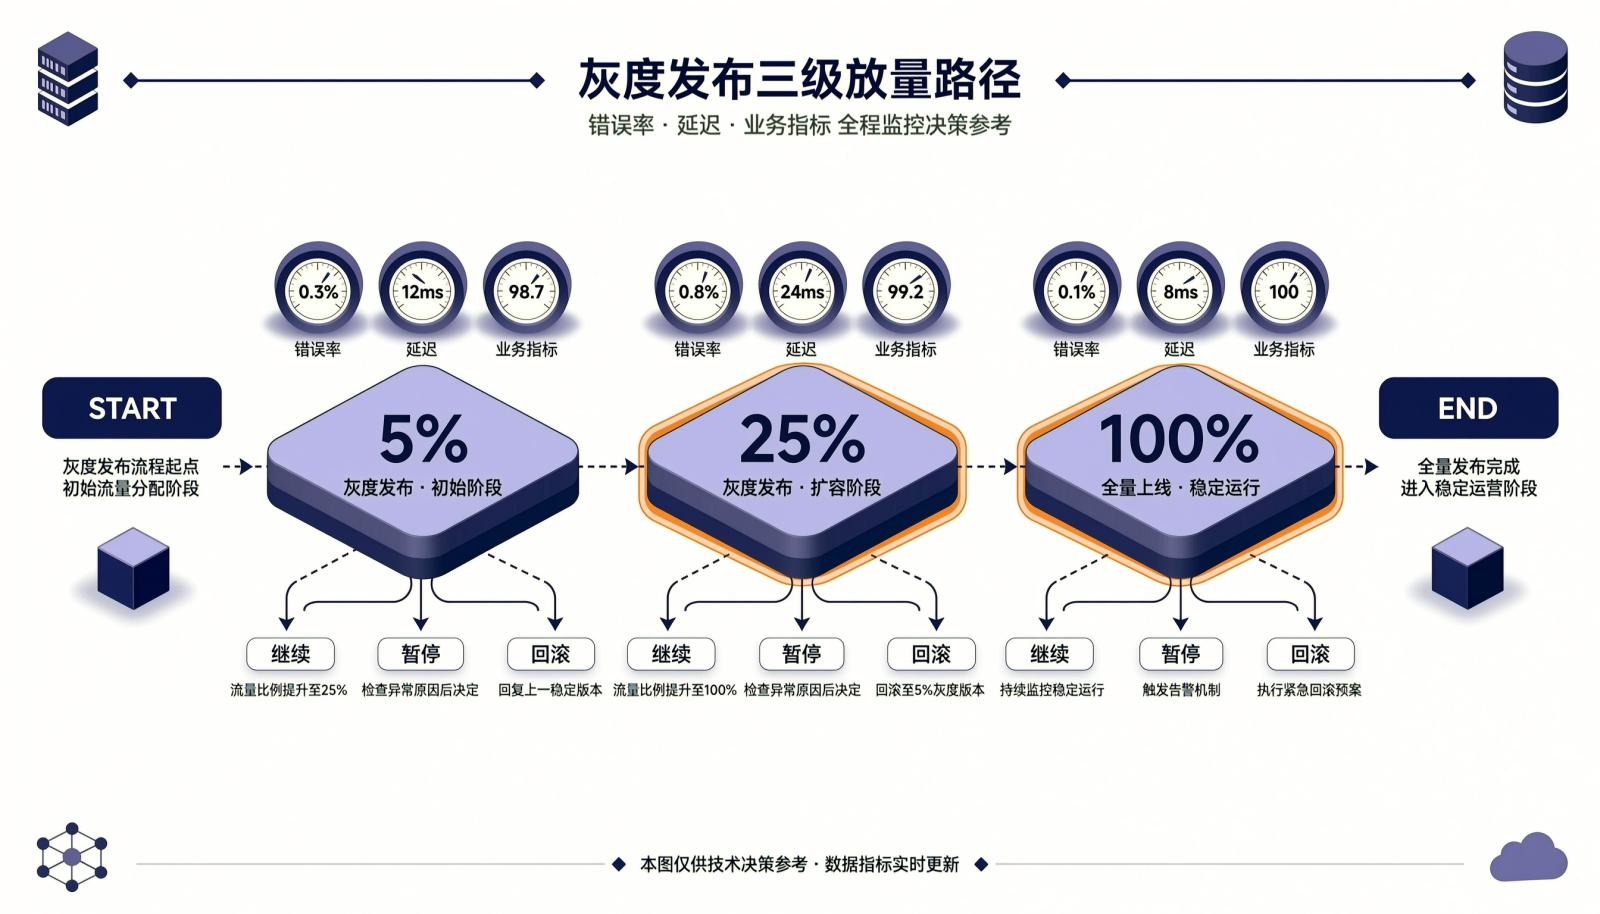
发布不必一次覆盖全部用户。可以先小范围放量,再逐步扩大,最后全量;每一级都设定观察窗口,盯错误率、延迟和关键业务指标。指标正常就继续,异常先暂停并定位,影响扩大时直接回滚。
3. 发布后:回滚与复盘按同一套记录
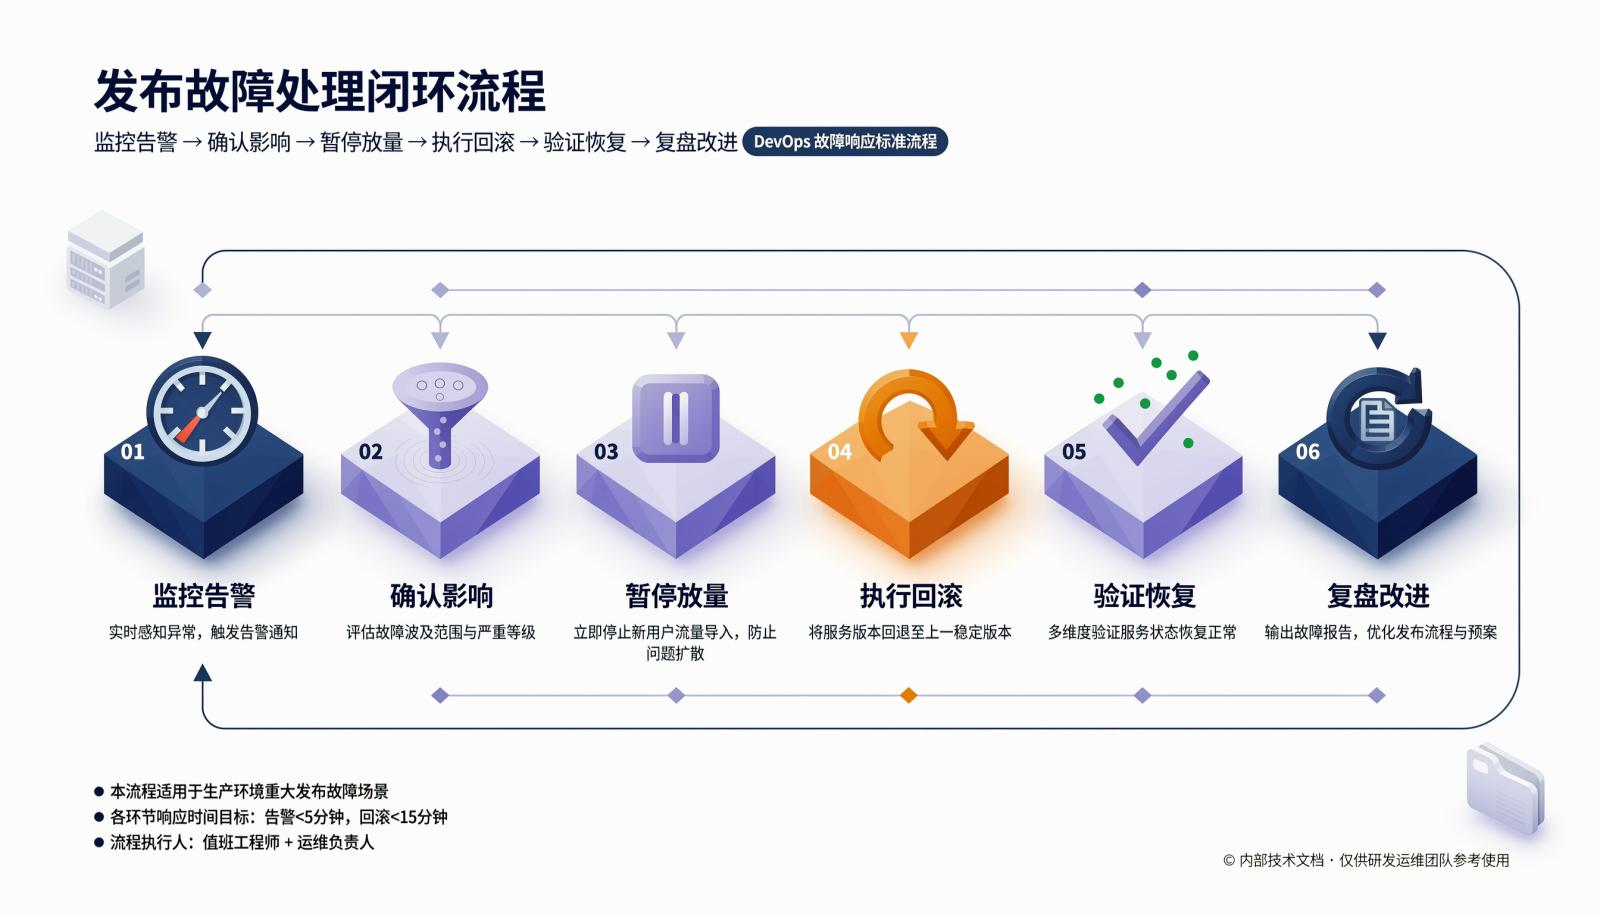
回滚不是失败,而是控制系统损失的手段。发现异常后先确认影响面,暂停放量,再执行预案并验证核心链路。恢复后把时间线、影响范围、根因和改进行动写进同一条发布记录,下一次发布才有一手依据。
研发项目管理工具用得好不好,不看字段有多少,而看一条需求能否顺利走到发布,并在出现问题时快速回溯。先把五个阶段的输入、输出和门禁跑通,再逐步增加自动化与度量,工具才会真正降低协作成本。
六、FAQ:使用中的四个常见问题
1. 小团队要不要一次启用全部模块?
先启用需求、任务、Bug和发布记录四个最小对象,跑通一个完整迭代后再加用例、文档和度量。模块越多,录入成本越高,早期反而不容易坚持。
2. 需求总变,怎么避免工具越管越乱?
把变更和新增分开。变更走影响评估和审批,新增回到需求池重新排序。只要每次变更都能回答影响谁、改什么、何时发,频率高不等于失控。
3. 发布后出问题,先回滚还是先修复?
看影响面和可逆性。涉及核心链路、数据错误或影响持续扩大时,优先回滚到上一个稳定版本;影响可控且修复路径明确时,再按预案修复并缩短观察窗口。
4. 看板上的数据多久复盘一次?
按迭代复盘流动效率,按月看趋势。每次只选一个瓶颈和一个改进动作,下一周期验证是否有效,不要把复盘开成数据汇报会。
参考资料
- 《什么是软件开发生命周期》,链接:https://www.ibm.com/cn-zh/think/topics/sdlc
- arXiv论文2404.06568(2024年):《基于多目标粒子群优化的测试序列生成》,链接:https://arxiv.org/abs/2404.06568
文章标题 :研发项目管理工具怎么用?从需求到发布全流程一次讲清 ,发布者 :项目管理研究院