项目管理系统从MySQL迁移到国产数据库,容易被低估的环节是历史数据:表能建、系统能起,但字段类型对不上、中文乱码、自增主键错位,往往要到割接后才暴露。IDC《2025年下半年中国关系型数据库软件市场跟踪报告》显示,2025年下半年中国关系型数据库软件市场规模达26.1亿美元,同比增长14.6%,国产数据库的替换正从外围系统走向核心系统。
以禅道为例,它在企业版8.4、旗舰版4.4中支持达梦数据库,并于2023年8月与达梦完成产品兼容互认证。系统层适配已经就绪,需要团队自己动手的是把历史数据在字段与编码两个维度对齐,下面按数据范围、迁移准备、迁移步骤、字段与编码、校验回退的顺序展开。
一、先分清:项目管理系统的历史数据包含哪些类型
不少团队把历史数据等同于数据库里的表,等到迁移时才发现还有几类数据不在表里。分清楚类型,后面的方案才不会漏项。
1. 结构化数据:表与字段
需求、任务、Bug、用例、项目、发布记录等主体数据,都以表和字段的形式存放,是迁移的主体。除了字段本身,还要关注默认值、是否可空、索引与外键约束。
2. 富文本与附件:不在数据库里的部分
需求描述、Bug复现步骤这类内容常以富文本保存,其中的图片和上传的附件则以文件形式存放在服务器磁盘或对象存储中。数据库迁移只搬走文本记录,文件需要单独迁移,并保持路径与记录一致。
3. 配置与权限:容易漏掉的一类
角色与权限、工作流与状态流转规则、自定义字段定义、系统配置项,同样属于历史数据。它们通常以配置或字典表的形式存在,迁移后需要重新核对,否则容易出现能登录、但权限和流程对不上的情况。
二、迁移前先盘清字段与编码底账
迁移质量取决于准备工作的细致程度。建议先产出一份可核对的字段清单和一份数据基线,而不是直接运行迁移工具。
1. 字段清单要核到什么粒度
清单要覆盖库、模式、表、字段名、类型、长度、是否可空、默认值、自增或序列、索引、外键和注释。两类信息容易被忽略:自增值与序列的当前值,以及标识符的大小写写法。
2. 编码基线要记录哪些内容
需要分别记录源库的字符集与排序规则、目标库安装时确定的字符集,以及两端的大小写敏感设置。这些设置不一致,是后续乱码和比较异常的主要来源。
3. 数据基线与备份
数据基线用于校验:逐表记录行数,对金额、工时、编号等关键字段计算求和或校验值。配合源库的全量备份,清单、基线与备份齐备,迁移才具备可回退的前提。
三、迁移路线:五步走
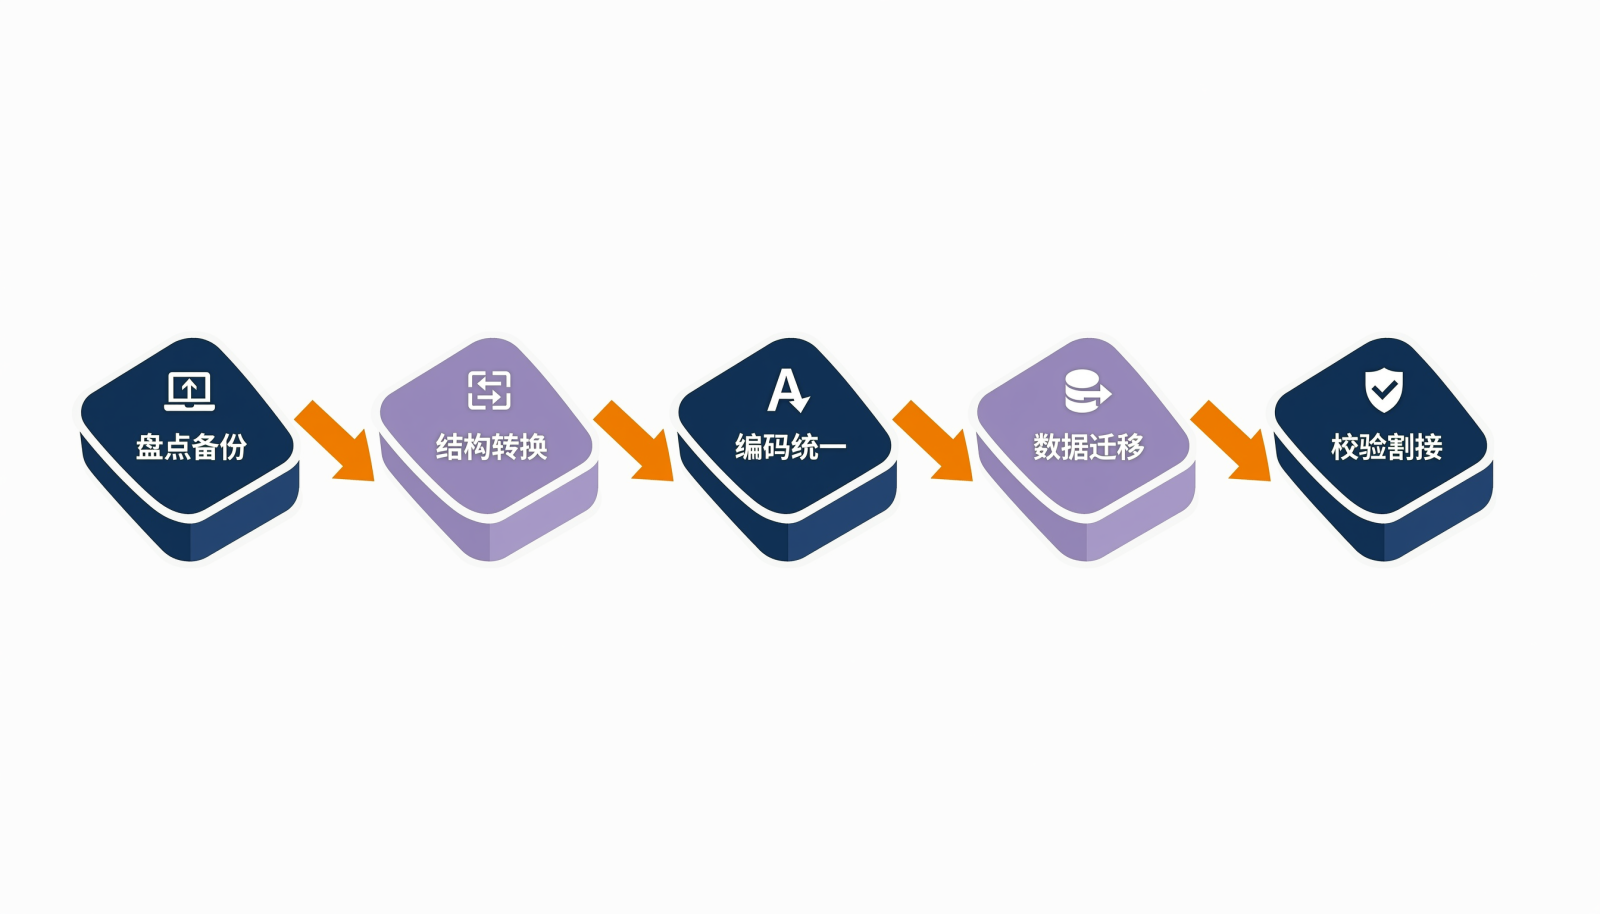
把迁移拆成五个可验证的步骤,每一步都给出成功信号,避免出现工具跑完就算完成的情况。
1. 盘点备份
产出字段清单与数据基线,并对源库做全量备份。成功信号是备份能在独立环境完整还原。
2. 编码统一
在目标库创建时就确定字符集,并把源库、目标库与客户端三处的编码对齐。这一步放在建表之前,是因为表会继承库的字符集,等建好表再改会更麻烦。成功信号是目标库字符集能覆盖源库的全部字符,且客户端连接编码与库一致。
3. 结构转换
在目标库创建模式与表,按映射规则改写建表语句。成功信号是脚本无报错,字段类型、长度、默认值与约束齐备;写入含中文、生僻字和表情符号的测试数据后,读回无乱码。
4. 数据迁移
结合目标数据库提供的官方迁移工具或逻辑导出导入方式,分批导入并控制单批数据量与提交频率。成功信号是导入过程无截断、无类型报错。
5. 校验割接
执行行数与内容比对,通过后再切换生产流量。比对的具体方式见后文校验部分。
如果团队还在评估系统侧的整体替换路径,可以先把系统适配和数据处理分开推进,参考禅道的国产替代方案。
四、字段类型映射:把宽松类型收敛到严格类型
源库常用的宽松类型,在国产数据库中往往要落到更严格的类型上。下表是高频字段的映射方向,可作为改写建表语句的起点。
| 原库常见类型 | 国产库常见类型 | 迁移要点 |
|---|---|---|
| TINYINT(1) | BOOLEAN | 布尔改为原生布尔,代码不再按0/1判断 |
| INT | INTEGER | 以目标库支持的类型名为准 |
| DATETIME | TIMESTAMP | 关注时区与精度设置 |
| TEXT / LONGTEXT | CLOB / TEXT | 大文本类型与字节上限需按目标库核对 |
| AUTO_INCREMENT | SERIAL / IDENTITY / 序列 | 迁移后把序列起始值同步到已用最大值 |
| VARCHAR(n) | VARCHAR2 / VARCHAR | 长度口径不同,需按目标库定义重新核对 |
映射不是简单替换,类型收敛后要逐字段确认长度和取值范围能否覆盖现有数据,尤其是接近上限的长文本字段。
还有两个高风险细节。部分兼容Oracle语法的国产数据库会把空字符串当作NULL处理,如果原库用空串区分未填写和无值,建议改成显式的状态字段;日期字段若存在0000-00-00这类零值,也需要在迁移前统一清洗,否则导入可能失败。
五、字符集与编码兼容:乱码和截断从哪里来
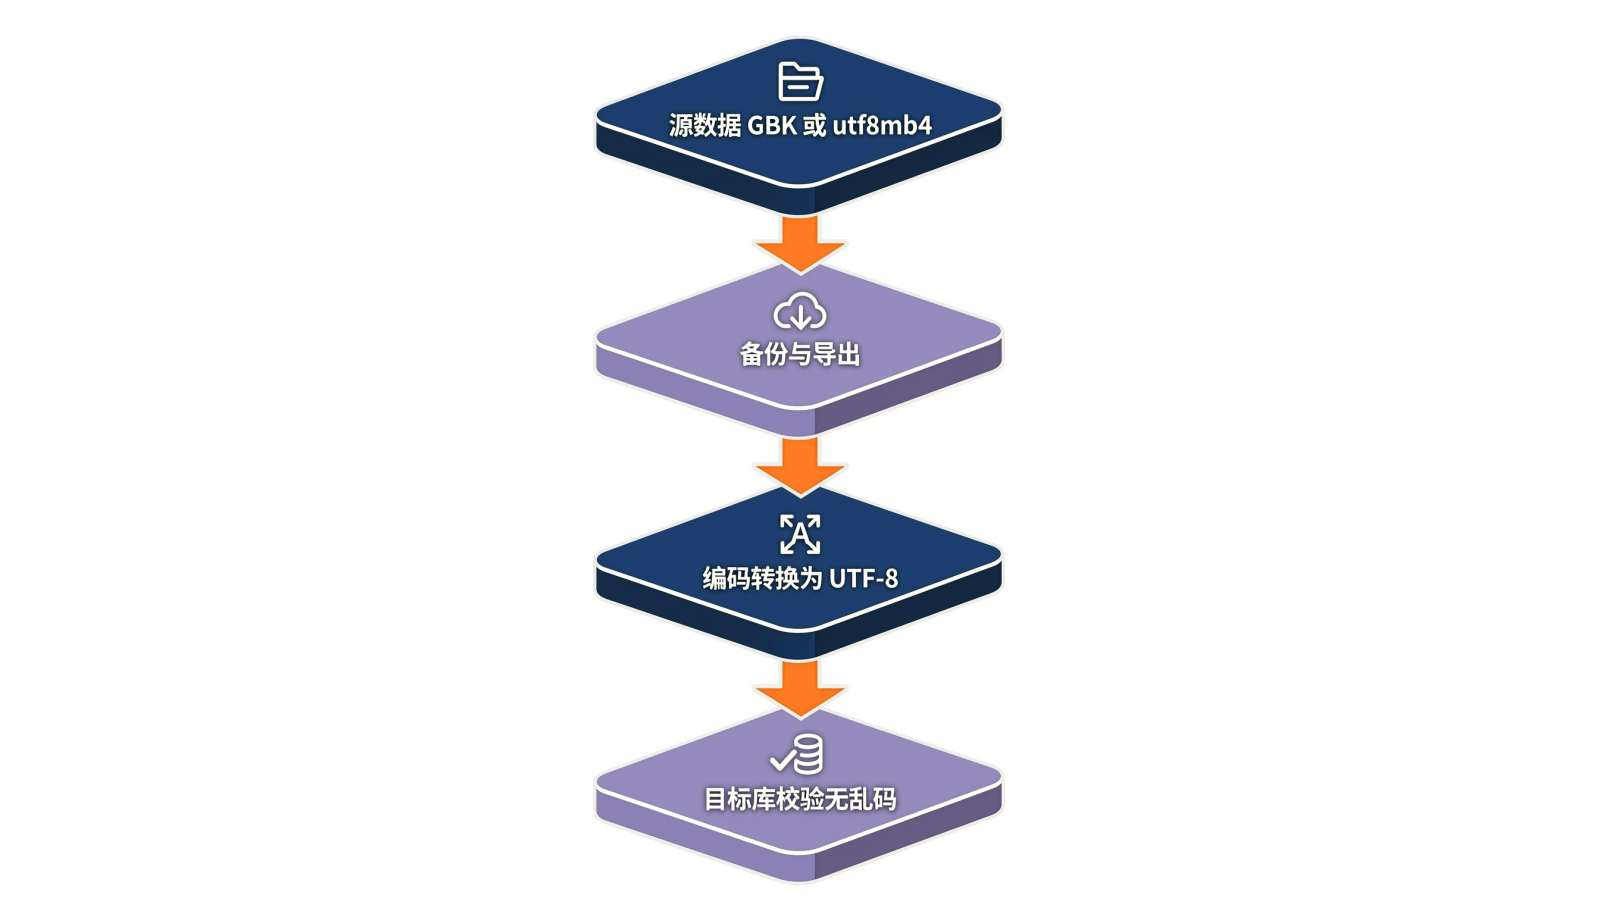
乱码和截断大多来自三处不一致:源库、目标库、客户端。
1. 字符集不一致
源库常见的utf8mb4能表示完整的Unicode字符,而目标库的字符集在安装时确定。如果目标字符集无法表达源库中的某些字符,转换时就可能丢失,迁移前建议做一次全量字符探测,确认没有无法表达的内容。
2. 字节长度不一致
同一个汉字在不同字符集下占用的字节数不同,utf8mb4下通常为3字节,GB18030下通常为2字节。字段长度的定义口径并不统一,只按字符数估算长度,中文长文本容易被截断,建议按字节重新核对字符串字段的长度上限。
3. 连接与排序规则不一致
应用侧需要在连接串里显式声明客户端编码。以MySQL驱动为例,常见写法是useUnicode=true&characterEncoding=utf8,其它数据库的驱动参数名并不相同,具体以目标数据库的官方驱动文档为准。标识符方面,以PostgreSQL为基础的国产数据库会把未加引号的标识符转为小写,迁移时统一采用全小写加下划线的命名可以减少排查成本。
六、迁移中另外几类常见语法差异
除字段与编码,还有几处语法差异会在割接前后集中暴露,建议在回归测试阶段逐项验证。
1. 分页写法
MySQL的LIMIT offset,size在部分国产数据库中不被识别,需要改为LIMIT size OFFSET offset。ORM配置和手写SQL里若有该写法,都要一并替换。
2. 自增主键与序列
AUTO_INCREMENT需要改为SERIAL、IDENTITY或显式序列。导入历史数据后建议重置序列,否则新增记录可能出现主键冲突。
3. Upsert写法
MySQL的INSERT ... ON DUPLICATE KEY UPDATE在PostgreSQL系数据库中要改写为ON CONFLICT ... DO UPDATE,并明确指定冲突列;在Oracle兼容型数据库中,通常改用MERGE INTO实现同样的语义。
4. 分组与日期函数
PostgreSQL系数据库对GROUP BY的要求更严格,非聚合字段需要全部出现在分组中;DATE_ADD、DATE_FORMAT等日期函数,也要替换为目标库支持的等价写法。
七、校验与回退:确认历史数据没有丢、没有乱
迁移完成不等于迁移正确,建议用迁移前的基线逐项比对。
1. 数据校验怎么比
常用方式包括:逐表行数比对;对金额、工时等数值字段做求和与极值比对;对中文与编号字段做随机抽样和乱码扫描;核对自增序列与外键引用是否连续完整。
2. 上线与回退怎么做
上线建议分两步:先在只读或双写环境下核验一段时间,确认查询结果与源库一致,再切换生产流量。迁移期间保留源库只读,并至少保留一个完整的备份周期,一旦发现数据缺失或乱码,可以直接回退,而不是在生产环境现场修补。
八、常见问题
1. 迁移大概要多久,服务一定要停吗?
主要取决于数据量和写入频率。历史数据的首轮全量导入通常可以离线完成;切换生产流量时,一般需要一次短暂的写入冻结,也就是暂停写入,用于同步增量并保证两端一致。数据量越大,这个窗口越需要提前评估。
2. 自定义字段和历史修改记录会一起迁过去吗?
只要它们以表和字段的形式存储,就会随数据库一起迁移;但如果自定义字段使用了原库特有的类型,需要先确认目标库是否有对应类型。历史修改记录的数据量通常较大,建议单独评估,必要时只保留近几年的记录。
3. 迁移后发现少量乱码,先查哪一环?
先确认乱码出现在哪一层:是数据库里已经乱码,还是应用读取之后才乱码。前者多为字符集转换问题,后者多为连接串或客户端编码问题。定位到具体层级,再决定是调整字符集还是修改连接配置,比直接改字段定义更稳妥。
4. 原库迁移完可以直接下线吗?
不建议立即下线。可以以只读方式保留一段时间,覆盖一次完整的业务周期,确认没有遗漏的查询或定时任务仍访问源库,再考虑下线。
文章标题 :支持国产数据库的项目管理系统怎么迁移历史数据:字段与编码兼容 ,发布者 :项目管理研究院